自助全基因组测序报告
除了常规的疾病和用药位点报告,基因组还能提示祖先从哪里来、身上有多少古人的血缘、血型与免疫的谱系、拷贝数和风险评分。
目录
以前都是给别人分析测序结果,好奇自己身上的序列能提示什么信息。于是我打开淘宝,找了一圈基因检测,感觉智商税偏多。最终还是联系了以前送样的测序公司,花了 1600 元,抽了 1 管紫帽血邮寄送样。等了大概 1 个月,公司给了一个原始数据的下载链接:88.8 Gb(约 888 亿个碱基),压缩后两个文件共 36.8 GB。因为可以自己分析,刚好系统整理了一下相关的知识。这篇文章首先讲 WGS 的原理,再用 AI 把 WGS 能分析的都跑了一遍,整理为了一个 skill。
一、测序的原理#
DNA 测序的血样一般用 EDTA 抗凝管(紫帽)保存,2–5 ml 足以。虽然市面上推出了棉签刮口腔的无痛采样法,但是还是血液里的 DNA 质量更高。所以我选择抽一管血寄过去。实际测序过程大致是三步:把 DNA 做成“文库”,上机测序,把一张张照片翻译成碱基。
从血到“文库”#
血液里只有白细胞有细胞核,DNA 就从白细胞里提取。测序仪一次只能读一两百个碱基,所以要先把 DNA 打碎,两端接上“接头”,做成由几亿个小片段组成的“文库”:
动画:建库流程——采血、提取白细胞 DNA、超声打断、两端接上接头、挑长度并 PCR 扩增、从片段两端各读 150 个碱基。
按测序公司的报告,我的文库就是这样做的:超声打断、末端修复、加 A 尾、连接头、筛选片段长度、PCR 扩增。比对完以后,从每对读段的位置可以算出原来的片段有多长:
我的读段对的片段长度:中位数 312 bp,平均 320.8 bp(标准差 70.6);37% 的片段短于 300 bp,两端各 150 个碱基的读段会重叠。
片段长度的中位数是 312 bp。两端各读 150 个碱基,大多数片段中间只剩一小段没读到;约 37% 的片段短于 300 bp,两端的读段会有重叠。
测序仪怎么“读”DNA:边合成边拍照#
Illumina 测序仪的原理叫“边合成边测序”1。文库被铺到一块叫 flow cell 的芯片上,芯片上有数以十亿计、排列整齐的纳米孔2;每个孔里的片段被原位扩增成几千份一模一样的拷贝(一个“簇”),这样荧光才够亮。然后一轮一轮地:加入带荧光、末端被“封住”的核苷酸 → 每条链只接上一个 → 拍照 → 切掉荧光和封口,进入下一轮。每拍一轮,就读出每个簇的一个碱基。
动画:边合成边测序——每一轮加入带荧光、3′ 端封闭的核苷酸,每条链接上一个碱基,拍蓝、绿两张照片(A 只亮蓝、T 只亮绿、C 都亮、G 都不亮),再切掉荧光和封口。相邻孔读出相同序列即光学重复。
NovaSeq X 系列为了拍得更快,只用蓝、绿两种荧光:只亮蓝是 A,只亮绿是 T,两个都亮是 C,都不亮是 G3。
我的数据就是在 NovaSeq X 系列上测的:读段名里的仪器编号 LH00190、LH00750、LH00281 都以 LH 开头。5.92 亿条读段来自 3 台测序仪的 3 条泳道,79% 来自其中一条。一条泳道里混着很多人的文库,靠接头里的“条形码”分开。
读得准不准:质量值#
每个碱基都带一个质量值 Q,表示读错的可能性:Q = −10 × log₁₀(读错的概率)4。Q20 是百分之一,Q30 是千分之一,Q40 是万分之一。NovaSeq X 只输出 4 档质量值(Q2、Q9、Q24、Q41),我的数据 97.5% 的碱基是最高档 Q41。下图是每一轮测序里“不是最高档”的碱基占多少:
每一轮测序的碱基质量(NovaSeq X 只有 Q2/Q9/Q24/Q41 四档):97.51% 的碱基达到 Q30 以上;即使最差的一轮,也有 95.9% 的碱基是最高档 Q41。越往读段末尾质量越缓慢下降。
越往读段后面,质量越是缓慢下降,读段开头的几轮也稍差一些;但即使在最差的那一轮,也有约 96% 的碱基是最高档。
读得够不够:为什么要读 20 多遍#
88.8 Gb 除以约 31 亿个碱基的基因组,相当于每个位置平均被读了约 29 遍。但读段是随机落在基因组上的,有的位置读得多,有的读得少。如果一个位置只读到三四次,可能恰好都来自同一份拷贝,杂合变异就漏掉了。
交互模拟:平均深度越高,杂合位点被漏看的概率越低(简化规则:两种碱基各至少 3 条读段);超过 30× 以后收益很小。
我的真实数据:
常染色体覆盖深度分布(不计参考序列里的空缺):平均 21.56×,比理想的泊松分布更宽。X 染色体 10.7×(男性只有一条)。
| 至少读到 | 占常染色体位置 |
|---|---|
| 1× | 99.7% |
| 5× | 99.2% |
| 10× | 98.3% |
| 15× | 90.5% |
| 20× | 62.4% |
| 30× | 7.6% |
去掉重复读段后,常染色体的平均深度是 21.6×(参考基因组里约 4.6% 是至今没测通的空缺,不算在内);98.3% 的位置至少读到 10 次,62% 至少 20 次5。实际分布比理想的泊松分布宽一些,因为 GC 含量过高或过低、重复序列多的区域本来就难测、难比对。
两个有意思的数字:X 染色体的深度只有 10.7×,因为男性只有一条 X,这也是从数据里判断性别的办法;线粒体 DNA 的深度高达 1,028×,因为每个细胞里有近百份线粒体 DNA。
从 29× 掉到 21.6×,主要是因为 27% 的读段对是重复的6:同一个 DNA 分子被读了不止一次。其中 21.8% 是“光学重复”,同一个分子“串”进了芯片上相邻的孔(上面动画的最后一步就是这种情况);5.5% 来自 PCR 扩增。重复读段不提供新信息,分析时每组只留一条。另外,样本混入别人 DNA 的比例估计只有 0.06%7。
二、数据长什么样:FASTQ、BAM、VCF#
公司交付的是两个 gz 压缩文件,合起来 36.8 GB。里面是所有小片段的集合(FASTQ),我们要通过参考基因组把这些片段拼接成我自己的基因组(BAM),然后算出我的基因组和参考基因组的不同(VCF)。下面用 2 号染色体上 TTN 基因里的一个常见变异来举例。TTN 基因编码肌联蛋白,是人体最大的蛋白。
FASTQ:原始读段#
FASTQ 是测序仪直接输出的格式8:每条读段 4 行,依次是名字、碱基、一个加号、每个碱基的质量。我的两个文件分别存读段对的第 1 端和第 2 端,各 2.96 亿条。下面是其中的一条:
原始 FASTQ 里的一条读段(4 行:名字、碱基、+、质量):
@LH00190:1151:25522TLT4:7:1209:49365:24231 1:N:0:GAACTGCAGA+GTTCGGTTAG
CGGTGCTACATTGATGATCTTAAGGCCAGATACTTTGTTGAAGAAGCTTATTTTGTATTTGTTGTCACTTGTTAGCTCTTTTCCATCCTTAAACCACTTAGTACTGAGTTCAGGGGTGCCAGCTACTGTACACTCCAAGGTACAGGTGTC
+
JJJJJJJJJJJJ9JJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJJ9JJJJJJJJJJJJJJJJJJJJJJJ
BAM:读段贴回参考基因组#
参考基因组源自人类基因组计划,在此基础上更迭了很多版了,它不属于一个人,是由一组人的 DNA 拼接构成,相当于一本字典。将我的基因片段和参考基因组比对以后,每条读段多了一个“地址”:在哪条染色体的第几个碱基、正着还是反着、比得好不好。这些信息存在 BAM 文件里9,按位置排好序、建了索引,所以我们就能像查地图一样调出任意一段。我的 BAM 有 29.7 GB,换成 CRAM 格式还能再压缩10。把覆盖同一个位置的读段叠在一起,就是“读段堆叠”:
TTN 基因上一个常见同义 SNP(chr2:178,714,003,rs2562839)处的 29 条读段堆叠:10 条是参考碱基 G,10 条是 A,约各一半,所以是杂合。
VCF:最后的差异清单#
真正需要解读的,只有“我和参考基因组不一样的地方”。变异检测把它们挑出来,写进 VCF 文件11:每行一个位点,前面是位置和碱基,最后一列是我的基因型和各种证据。
这个位点在 VCF 里的一行(DeepVariant 输出):
#CHROM POS ID REF ALT QUAL FILTER INFO FORMAT zhh
chr2 178714003 . G A 43.5 PASS . GT:GQ:DP:AD:VAF:MID:PL 0/1:43:20:10,10:0.5:small_model:43,0,59
我的 VCF 一共约 497 万个变异:
一个人和参考基因组相差几百万个位置,完全正常:参考基因组本身只是少数几个人的 DNA 拼起来的12,这些差异有没有临床意义需要进一步解读。
从 37 GB 到 0.1 GB#
每一步的文件大小:
| 文件 | 大小 |
|---|---|
| FASTQ(两个压缩文件) | 36.8 GB |
| BAM(比对后) | 29.7 GB |
| gVCF(含无变异区块) | 1.5 GB |
| VCF(只有变异) | 106 MB |
BAM 和 FASTQ 差不多大:读段一条没少,只是多了位置信息。到了 VCF 只剩约 0.1 GB,是原始数据的三百多分之一。gVCF 比 VCF 多记了“哪些位置确认和参考一样”,一般和别人的数据合并分析时要用到。这里的原始数据我存云盘了,最好一直留着:将来有了更好的变异检测方法、更新的参考基因组,还能从头再分析一遍。
三、WGS 分析的原理#
整个流程在我自己的一台工作站上跑:比对耗时 27.5 分钟,找变异耗时 27 分钟,用的是一块号称“电子茅台”的 RTX 4090 显卡和 NVIDIA 的 GPU 加速版本13。
比对:给 5.9 亿条读段找位置#
参考基因组用的是 GRCh3812。比对软件 BWA-MEM14,15 的思路是“先查索引,再细比”:
动画:BWA-MEM 比对原理——从读段里取完全匹配的“种子”,在参考基因组的 FM 索引里查到候选位置,再逐个碱基延伸打分,得分最高的位置胜出。
比对完再标出重复读段、按位置排序,就得到上一章的 BAM。我的读段 99.82% 都能比对上;剩下 0.18%(107 万条)在人类参考基因组上找不到位置,它们大多不是人的 DNA。血液里如果有病毒,它的读段也只会落在这一堆里,所以第六章就在这 107 万条里找病毒。
找变异:把读段堆叠当成图片来看#
传统的变异检测靠统计模型:数一数每个位置有多少读段支持参考碱基、多少支持别的碱基,再把质量值算进去。DeepVariant16 换了个思路:把读段堆叠画成一张多通道的“图片”,交给为识别照片设计的卷积神经网络来判断基因型。
动画:DeepVariant 把读段堆叠画成多通道图片(碱基、碱基质量、比对质量、链方向、是否支持变异、是否与参考不同),由卷积神经网络输出三种基因型的概率。
如果同时分析几个人,就要用 GLnexus17 把每个人的 gVCF 合并起来,让所有人在同一个位置用同一个标准判断。
注释:这个变异做了什么#
VCF 里只有位置和碱基。要知道一个变异“做了什么”,需要注释18:它在哪个基因里,改不改变氨基酸,在人群中有多常见(gnomAD19),有没有被报告过致病(ClinVar20),以及各种预测工具的打分:错义变异看 REVEL21、AlphaMissense22,剪接看 SpliceAI23。
上面那个例子注释出来是:TTN 基因 c.26655C>T,第 8885 位还是丝氨酸(同义变异);在 gnomAD 里 31% 的染色体带 A,东亚人中 65%。非常常见、不改变蛋白,所以可以认为属于无害的常见变异。
几百万个变异里,挑出值得看的#
从全部变异筛到需要人工看的变异:
| 步骤 | 变异数 |
|---|---|
| 全部变异 | 4,970,671 |
| 落在基因外显子附近(±50 bp) | 369,448 |
| 可能改变蛋白质或剪接 | 19,667 |
| 其中人群频率 < 1% | 690 |
| 预测有害或数据库记为致病,需要人工看 | 49 |
| ACMG 84 个可干预基因里确认致病 | 0 |
绝大多数变异在基因之间或内含子里。落在基因外显子附近、又可能改变蛋白或剪接的不到两万个;其中在人群里罕见(频率低于 1%)的只有 690 个;再按功能预测和 ClinVar 记录筛,剩下 49 个需要人来看。结合读段质量和文献逐个核对,按 ACMG/AMP 标准24分类后:ACMG 推荐报告的 84 个可干预基因25里没有致病变异,其余大多是意义不明或良性。隐性病携带的结果不在这里展开(见第八章)。
后面的内容介绍#
| 章节 | 想回答的问题 | 原理 | 主要工具和数据 |
|---|---|---|---|
| 四、我从哪里来 | 和哪些现代、古代人群最像,由哪些祖先混合而成 | 比较几十万个位点上的等位基因频率,相近的人群共享更多“遗传漂移” | smartpca26、ADMIXTOOLS27、AADR28 |
| 每一段染色体像北方还是南方 | 先把两份拷贝分开(定相),再沿着染色体逐段和参考人群比 | Beagle29、RFMix30 | |
| 身上有多少尼安德特人 | 找“非洲人里没有、又成片出现”的变异,再和古人类基因组比 | hmmix31 | |
| 父母是不是近亲 | 找两份拷贝完全相同的长片段 | bcftools roh32 | |
| 父系、母系是哪一支 | 把 Y 染色体和线粒体的变异放到系统树上 | Yleaf33、HaploGrep 334 | |
| 五、身体年龄 | 血液 DNA 里的衰老信号 | 深度之比、低比例的体细胞突变、数端粒重复 | TelSeq35 |
| 六、免疫与血液 | 血型、HLA 与 KIR、病毒 | 关键位点换算成抗原;读段和已知等位基因比;比不上人类的读段按序列片段分类 | T1K36、Kraken237 |
| 七、拷贝数 | 哪些基因多一份、少一份 | 某段的深度和全基因组平均深度之比 | 自己写的脚本 |
| 八、医学相关解读 | 致病变异和用药 | 上面这套筛选,加上药物基因组的指南 | PharmCAT38、CPIC39 |
| 九、多基因风险 | 某种病的“基因背景”高不高 | 成百上千个小效应变异加权求和,再和同族人群比 | PGS Catalog40、PLINK 241 |
| 十、重复扩增 | 有没有致病的重复扩增 | 数跨过重复区的读段里有几个重复单元 | ExpansionHunter42 |
四、我的人种起源#
在东亚遗传版图上,我站在哪儿#
古 DNA 数据集有收集古人的 DNA,是解读自己起源的最好参考。如果把几十个东亚现代人群的基因组压缩成两个坐标:横轴大致是“从北到南”,纵轴把日本列岛单独拉开。我落在北方汉族(北京)和南方汉族之间、更靠南方汉族一侧,和 HGDP43 的汉族样本、土家族很接近。
切到“古代个体”看更有意思:三千多个古人投影到同一坐标系,我正好站在黄河中下游新石器晚期到商周的人群和福建、澎湖、台湾的新石器到铁器时代人群之间。
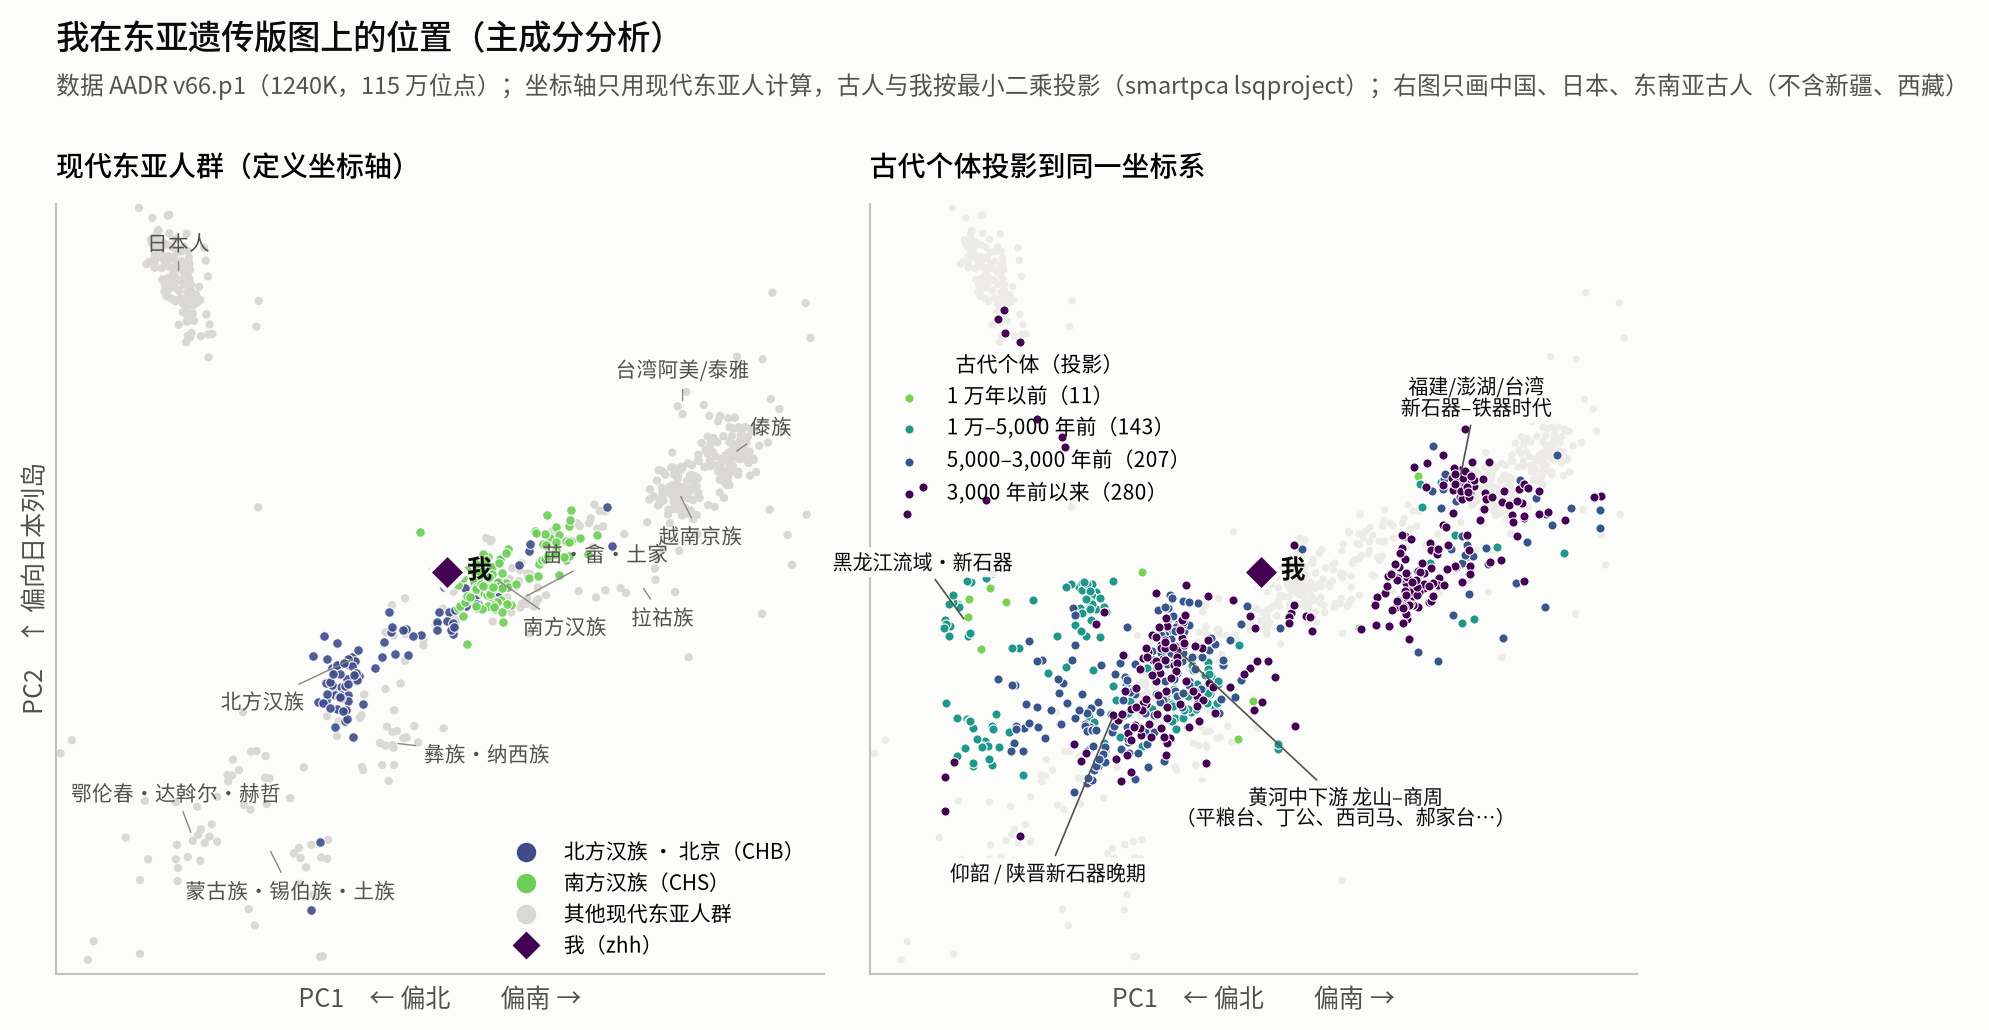
现代东亚人群的主成分分析(PC1 大致从北到南,PC2 把日本列岛拉开),古代个体和我投影到同一坐标系。离我最近的现代人群:汉族(HGDP);南方汉族(1000G);土家族;畲族;苗族。离我最近的古代人群(至少 3 人):贵州 Dasongshan · 明代;河南八里岗 · 龙山文化;河南八里岗 · 石家河文化;山东潍坊 · 周代;山东丁公 · 龙山文化;河南八里岗 · 东周。
方法:古 DNA 数据集 AADR v66.p128(2026 年 6 月)的 1240K 位点,共 115 万个 SNP;我在这些位点上的基因型直接从全基因组数据里读出(坐标从 hg19 换算到 hg38,99.8% 有结果)。smartpca26 只用现代东亚人计算坐标轴,古人和我按最小二乘投影。现代人群来自 1000 Genomes44,45 和 HGDP。
和古人比:我和谁最像#
对 500 多个东亚及周边的古代人群,各算一个“和我共享多少遗传历史”的分数(outgroup f3,越大越像)。颜色越深越像。可以按时间段切换,拖动下方色条可以只看某个分数段。
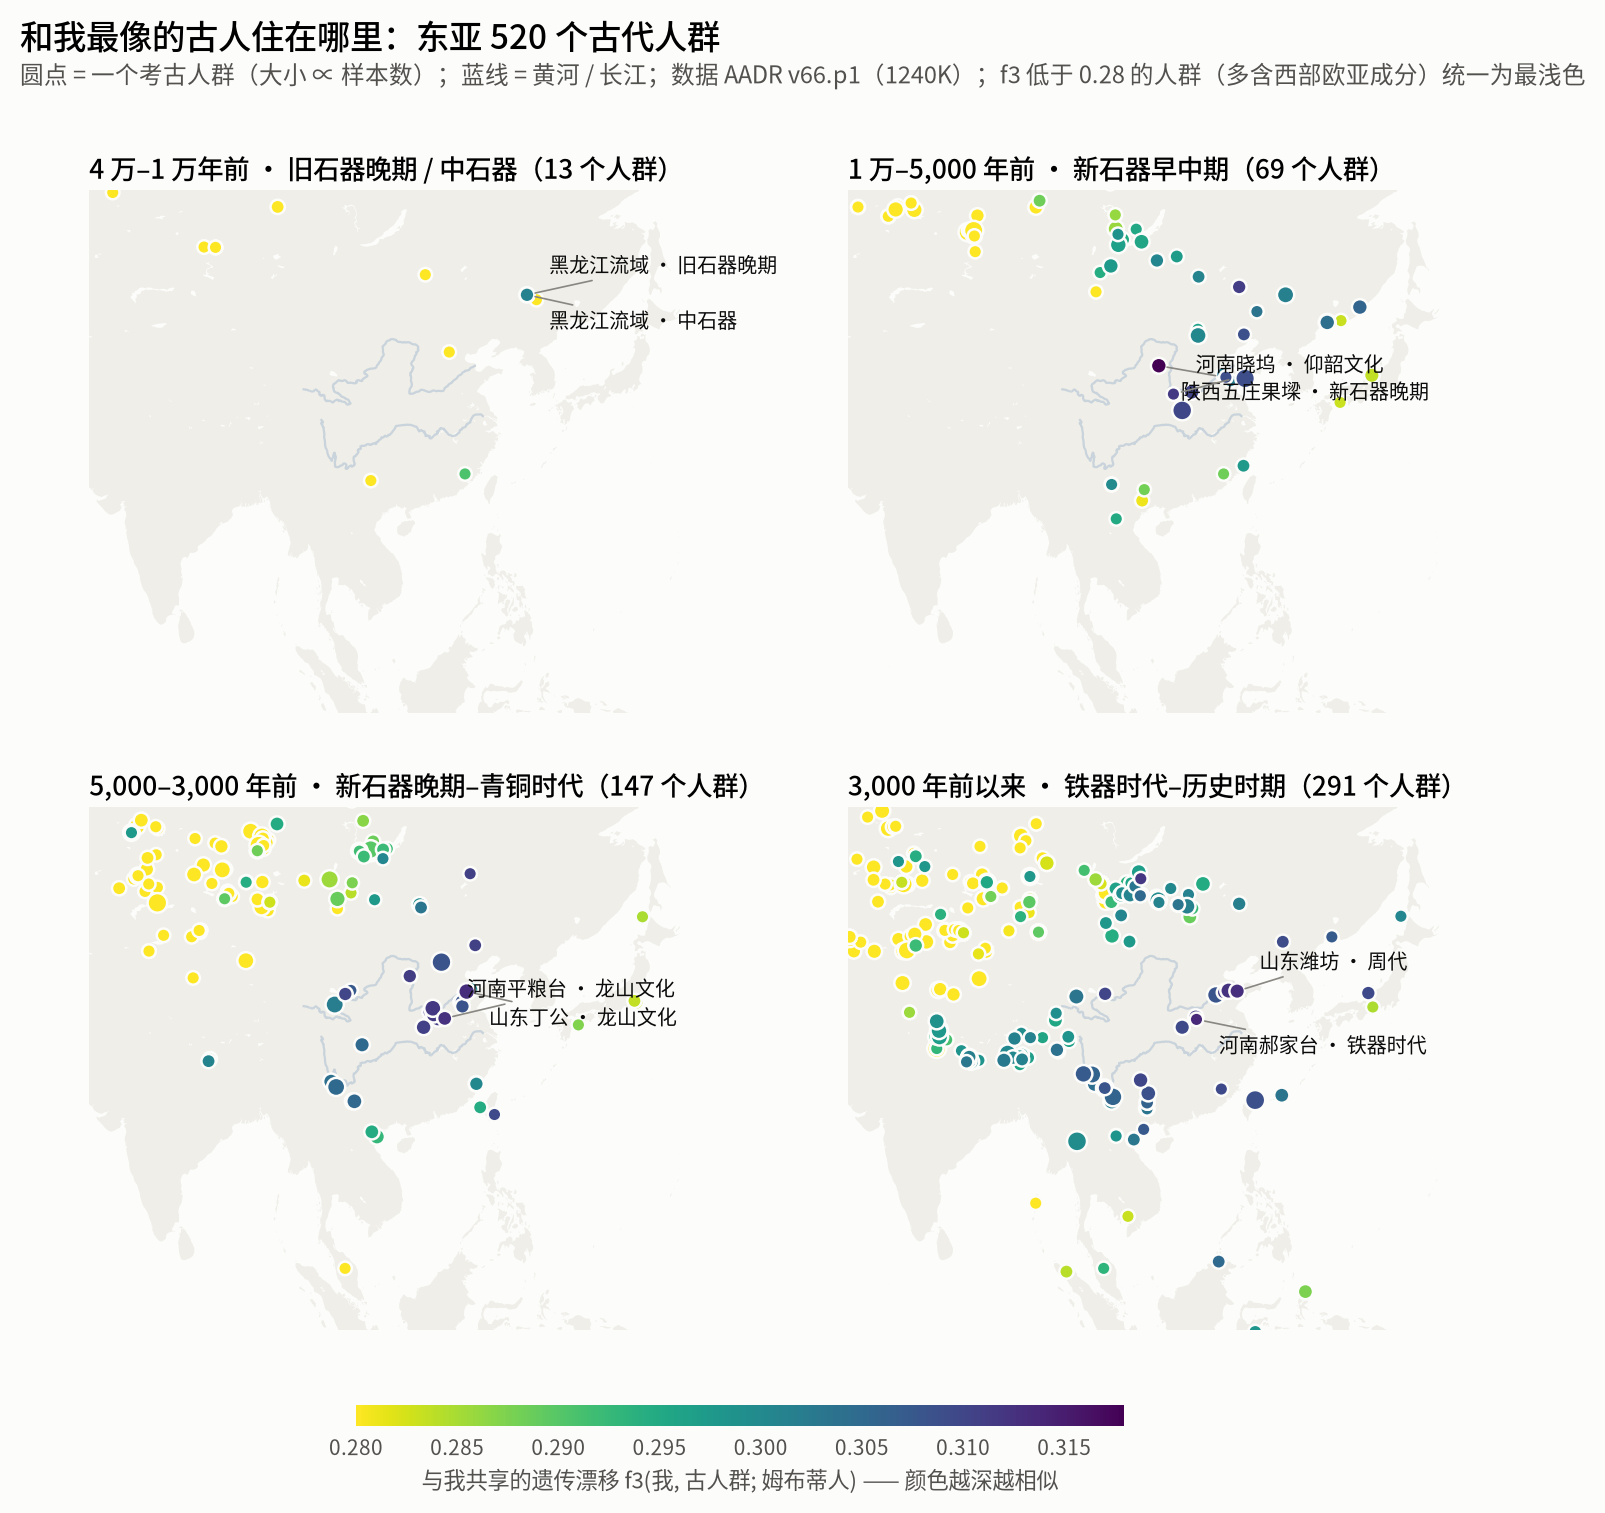
东亚及周边 543 个古代人群的 outgroup f3(我, 古代人群; 姆布蒂) 地图(越大越像我)。最高的十个:陕西五庄果墚 · 新石器晚期(0.3180);河南郝家台 · 铁器时代(0.3135);山东丁公 · 龙山文化(0.3130);山东潍坊 · 周代(0.3128);河南平粮台 · 龙山文化(0.3125);山东淄博桐林 · 东周(0.3124);蒙古 Selenge · 匈奴时期(0.3119);河南西司马 · 晚商(0.3117);河南晓坞 · 仰韶文化(0.3117);河南瓦店 · 龙山文化(0.3117)。
不管哪个时间段,对我而言,最像的点(颜色最深)始终在黄河中下游:新石器时代的河南晓坞(仰韶文化)、陕西五庄果墚,龙山文化的河南平粮台、山东丁公46–48,再到商周时期的河南、山东人群。
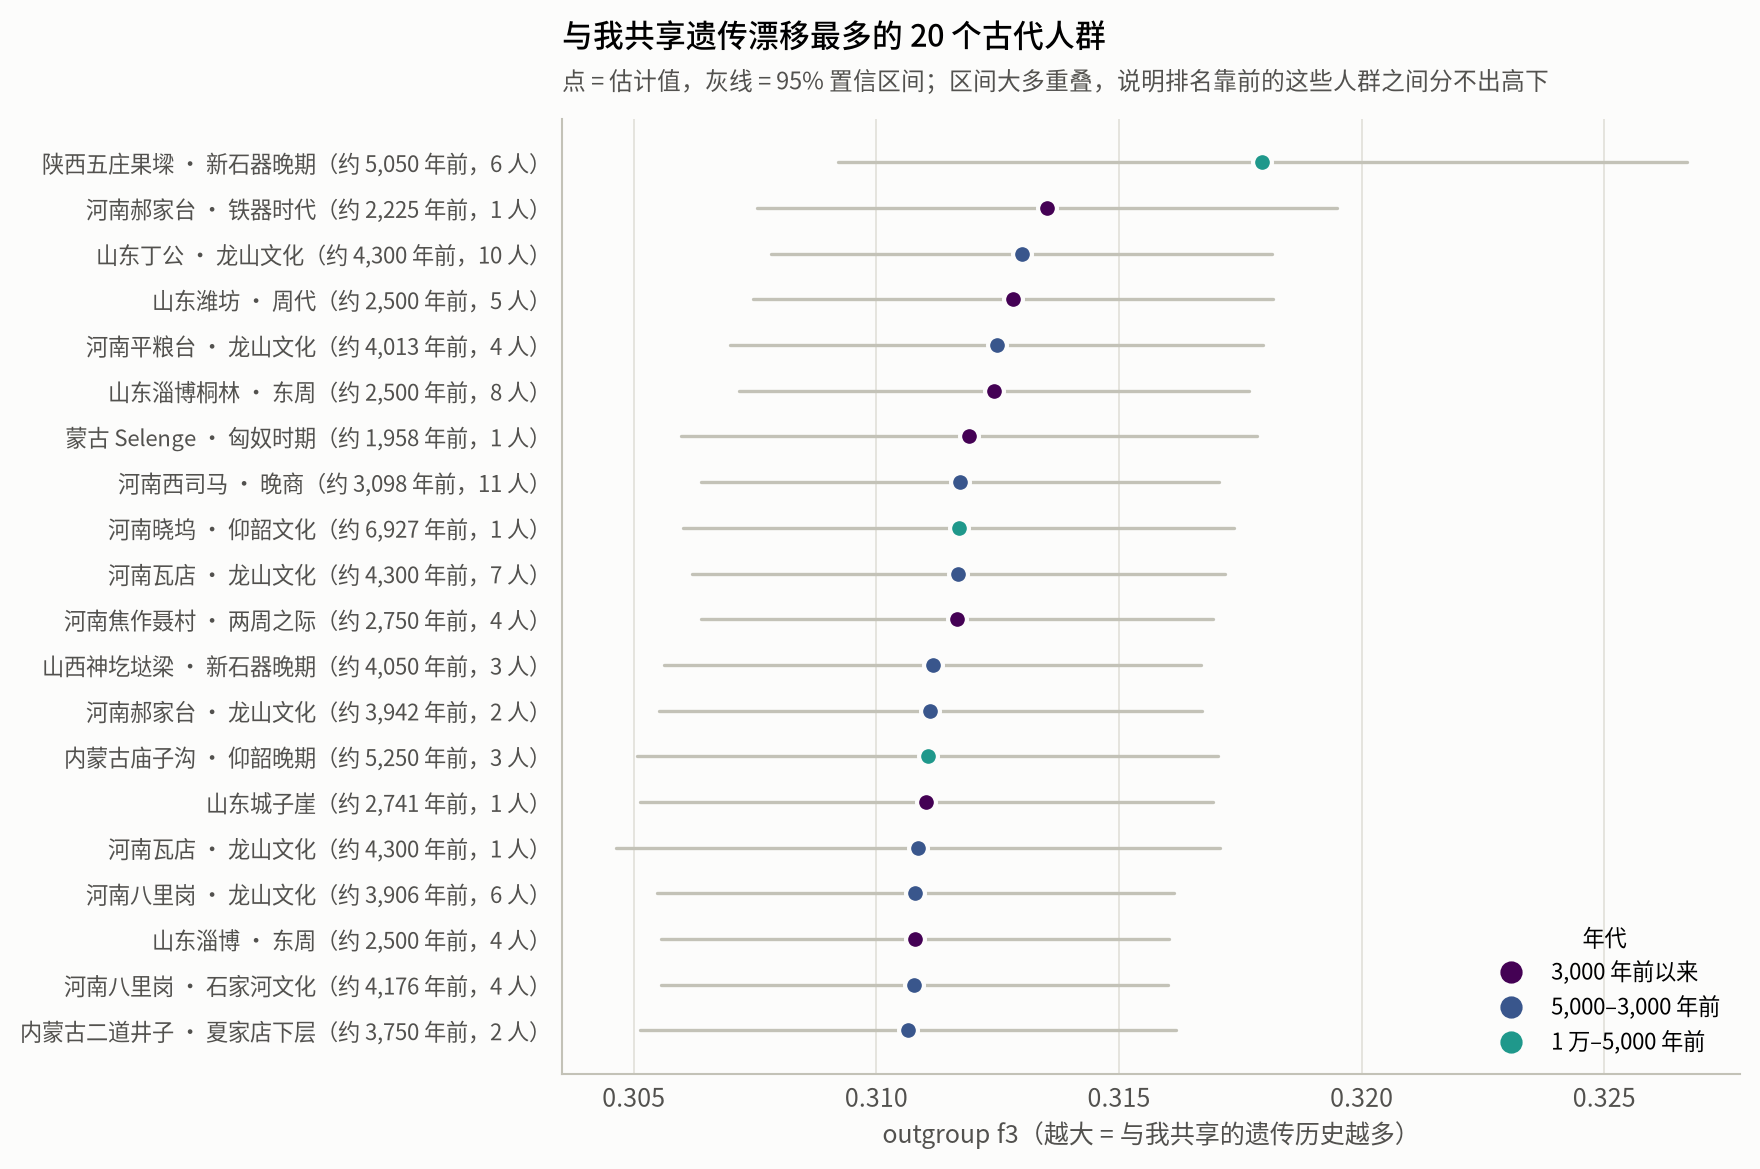
与我共享遗传漂移最多的 20 个古代人群(outgroup f3,95% 置信区间大量重叠):
| 名次 | 人群/遗址 | 年代 | 人数 | f3 | 95% 区间 |
|---|---|---|---|---|---|
| 1 | 陕西五庄果墚 · 新石器晚期 | 约 5,050 年前 | 6 | 0.3180 | 0.3092–0.3267 |
| 2 | 河南郝家台 · 铁器时代 | 约 2,225 年前 | 1 | 0.3135 | 0.3075–0.3195 |
| 3 | 山东丁公 · 龙山文化 | 约 4,300 年前 | 10 | 0.3130 | 0.3078–0.3182 |
| 4 | 山东潍坊 · 周代 | 约 2,500 年前 | 5 | 0.3128 | 0.3075–0.3182 |
| 5 | 河南平粮台 · 龙山文化 | 约 4,013 年前 | 4 | 0.3125 | 0.3070–0.3180 |
| 6 | 山东淄博桐林 · 东周 | 约 2,500 年前 | 8 | 0.3124 | 0.3072–0.3177 |
| 7 | 蒙古 Selenge · 匈奴时期 | 约 1,958 年前 | 1 | 0.3119 | 0.3060–0.3178 |
| 8 | 河南西司马 · 晚商 | 约 3,098 年前 | 11 | 0.3117 | 0.3064–0.3171 |
| 9 | 河南晓坞 · 仰韶文化 | 约 6,927 年前 | 1 | 0.3117 | 0.3060–0.3174 |
| 10 | 河南瓦店 · 龙山文化 | 约 4,300 年前 | 7 | 0.3117 | 0.3062–0.3172 |
| 11 | 河南焦作聂村 · 两周之际 | 约 2,750 年前 | 4 | 0.3117 | 0.3064–0.3169 |
| 12 | 山西神圪垯梁 · 新石器晚期 | 约 4,050 年前 | 3 | 0.3112 | 0.3056–0.3167 |
| 13 | 河南郝家台 · 龙山文化 | 约 3,941 年前 | 2 | 0.3111 | 0.3055–0.3167 |
| 14 | 内蒙古庙子沟 · 仰韶晚期 | 约 5,250 年前 | 3 | 0.3111 | 0.3051–0.3170 |
| 15 | 山东城子崖 | 约 2,741 年前 | 1 | 0.3110 | 0.3051–0.3169 |
| 16 | 河南瓦店 · 龙山文化 | 约 4,300 年前 | 1 | 0.3109 | 0.3046–0.3171 |
| 17 | 河南八里岗 · 龙山文化 | 约 3,905 年前 | 6 | 0.3108 | 0.3055–0.3161 |
| 18 | 山东淄博 · 东周 | 约 2,500 年前 | 4 | 0.3108 | 0.3056–0.3160 |
| 19 | 河南八里岗 · 石家河文化 | 约 4,176 年前 | 4 | 0.3108 | 0.3056–0.3160 |
| 20 | 河南八里岗 · 屈家岭文化 | 约 4,582 年前 | 2 | 0.3107 | 0.3049–0.3164 |
前 20 名几乎都来自河南、山东、陕西、山西,另有内蒙古的仰韶晚期遗址(庙子沟)和夏家店下层文化遗址(二道井子)46。不过它们的置信区间大量重叠:这些人群彼此本来就很像,统计上分不出谁“最”像我。综合看的话,我的主体祖源和黄河流域新石器时代以来的人群一脉相承。
有意思的是,排名里有一位葬在蒙古国色楞格省匈奴时期墓地的人(直接测年为公元前 52 年至公元 62 年)49,和我的相似度与中原古人不相上下。匈奴是一个遗传上非常多元的草原联盟,其中本来就有遗传上与中原人群相近的成员。
方法:ADMIXTOOLS27 qp3Pop 计算 f3(我, 古代人群; 姆布蒂人);只画覆盖 ≥ 3 万个位点的人群。地图只画海岸线和黄河、长江,不画国界。
把基因组拆成“北方源 + 南方源”#
qpAdm 是古 DNA 研究里检验“某人群能否看成几个来源的混合、各占多少”的标准方法50,51。我用这两个来源建模:黄河中游的龙山时代农人(河南平粮台、郝家台、瓦店,山西神圪垯梁等)46,48,和南方沿海人群(福建昙石山、溪头及澎湖的新石器晚期人群52,或台湾汉本遗址的铁器时代人群47)。
qpAdm 两源模型:我的基因组 = 北方源(黄河流域新石器晚期)+ 南方源;p ≥ 0.05 表示两源模型能解释。
| 模型 | 外群 | 北方源 | 南方源 | 标准误 | p |
|---|---|---|---|---|---|
| 黄河龙山 + 福建/澎湖新石器 | 基础外群 | 74.9% | 25.1% | 10.3% | 0.14 |
| 黄河龙山 + 福建/澎湖新石器 | 扩展外群 | 92.4% | 7.6% | 5.1% | 0.12 |
| 黄河龙山 + 台湾汉本 | 基础外群 | 70.2% | 29.8% | 9.7% | 0.29 |
| 黄河龙山 + 台湾汉本 | 扩展外群 | 86.2% | 13.8% | 6.2% | 0.18 |
| 山东龙山 + 福建/澎湖新石器 | 基础外群 | 56.7% | 43.3% | 9.3% | 0.0048 |
| 山东龙山 + 福建/澎湖新石器 | 扩展外群 | 85.4% | 14.6% | 4.8% | 0.0000012 |
| 山东龙山 + 台湾汉本 | 基础外群 | 55.1% | 44.9% | 7.7% | 0.067 |
| 山东龙山 + 台湾汉本 | 扩展外群 | 75.1% | 24.9% | 5.5% | 0.000058 |
| 黄河仰韶 + 台湾汉本 | 基础外群 | 75.3% | 24.7% | 12.2% | 0.14 |
| 黄河仰韶 + 台湾汉本 | 扩展外群 | 81.4% | 18.6% | 6.2% | 0.16 |
几种来源组合下,两源模型都能解释我的基因组构成(p ≥ 0.05),北方成分在 约 70% 到 90% 之间,具体数字取决于外群怎么选;只用黄河流域一个来源则不够(被拒绝)。
切到“我 vs 单个汉族个体”,用同一个模型(黄河龙山 + 台湾汉本,基础外群)比一比:6 位北京汉族的北方成分在 86%–100% 之间,6 位南方汉族在 42%–75%,6 位 HGDP 汉族在 39%–70%,我是 70%——正好落在北方和南方汉族之间,和主成分分析的位置一致。还有一个细节:多数北京汉族个体两源模型就够了,而多数南方汉族个体被拒绝,说明他们还带着这两个来源之外的成分(比如更西南的人群)。
这和已发表研究对现代汉族的结论一致:主体来自黄河流域新石器时代农人,再混入不同比例的南方成分,越往南比例越高47,52。
方法:ADMIXTOOLS 8 qpAdm(allsnps)。基础外群:姆布蒂、乌斯季伊希姆、科斯坚基 14、巴布亚、翁格、田园洞、甘吉达列、日本绳文、黑龙江流域新石器、蒙古新石器47,53–61;扩展外群再加山东、福建、广西的早期新石器个体52,62。另外几种来源组合里的山东龙山人群来自丁公、城子崖、尹家城48,63。“单个汉族个体”一栏用北京汉族、南方汉族、HGDP 汉族各随机 6 人,单人作为目标与我统计功效相当。
染色体涂色:哪一段像北方、哪一段像南方#
qpAdm 给的是全基因组的平均比例。如果把每条染色体的两份拷贝分开(定相),再用北京汉族代表“北方东亚”、西双版纳傣族和越南京族代表“南方东亚”,就能给染色体的每一段“涂色”。按住 Ctrl 滚轮或拖动底部滑块可以放大某一段,悬停看每段的位置。
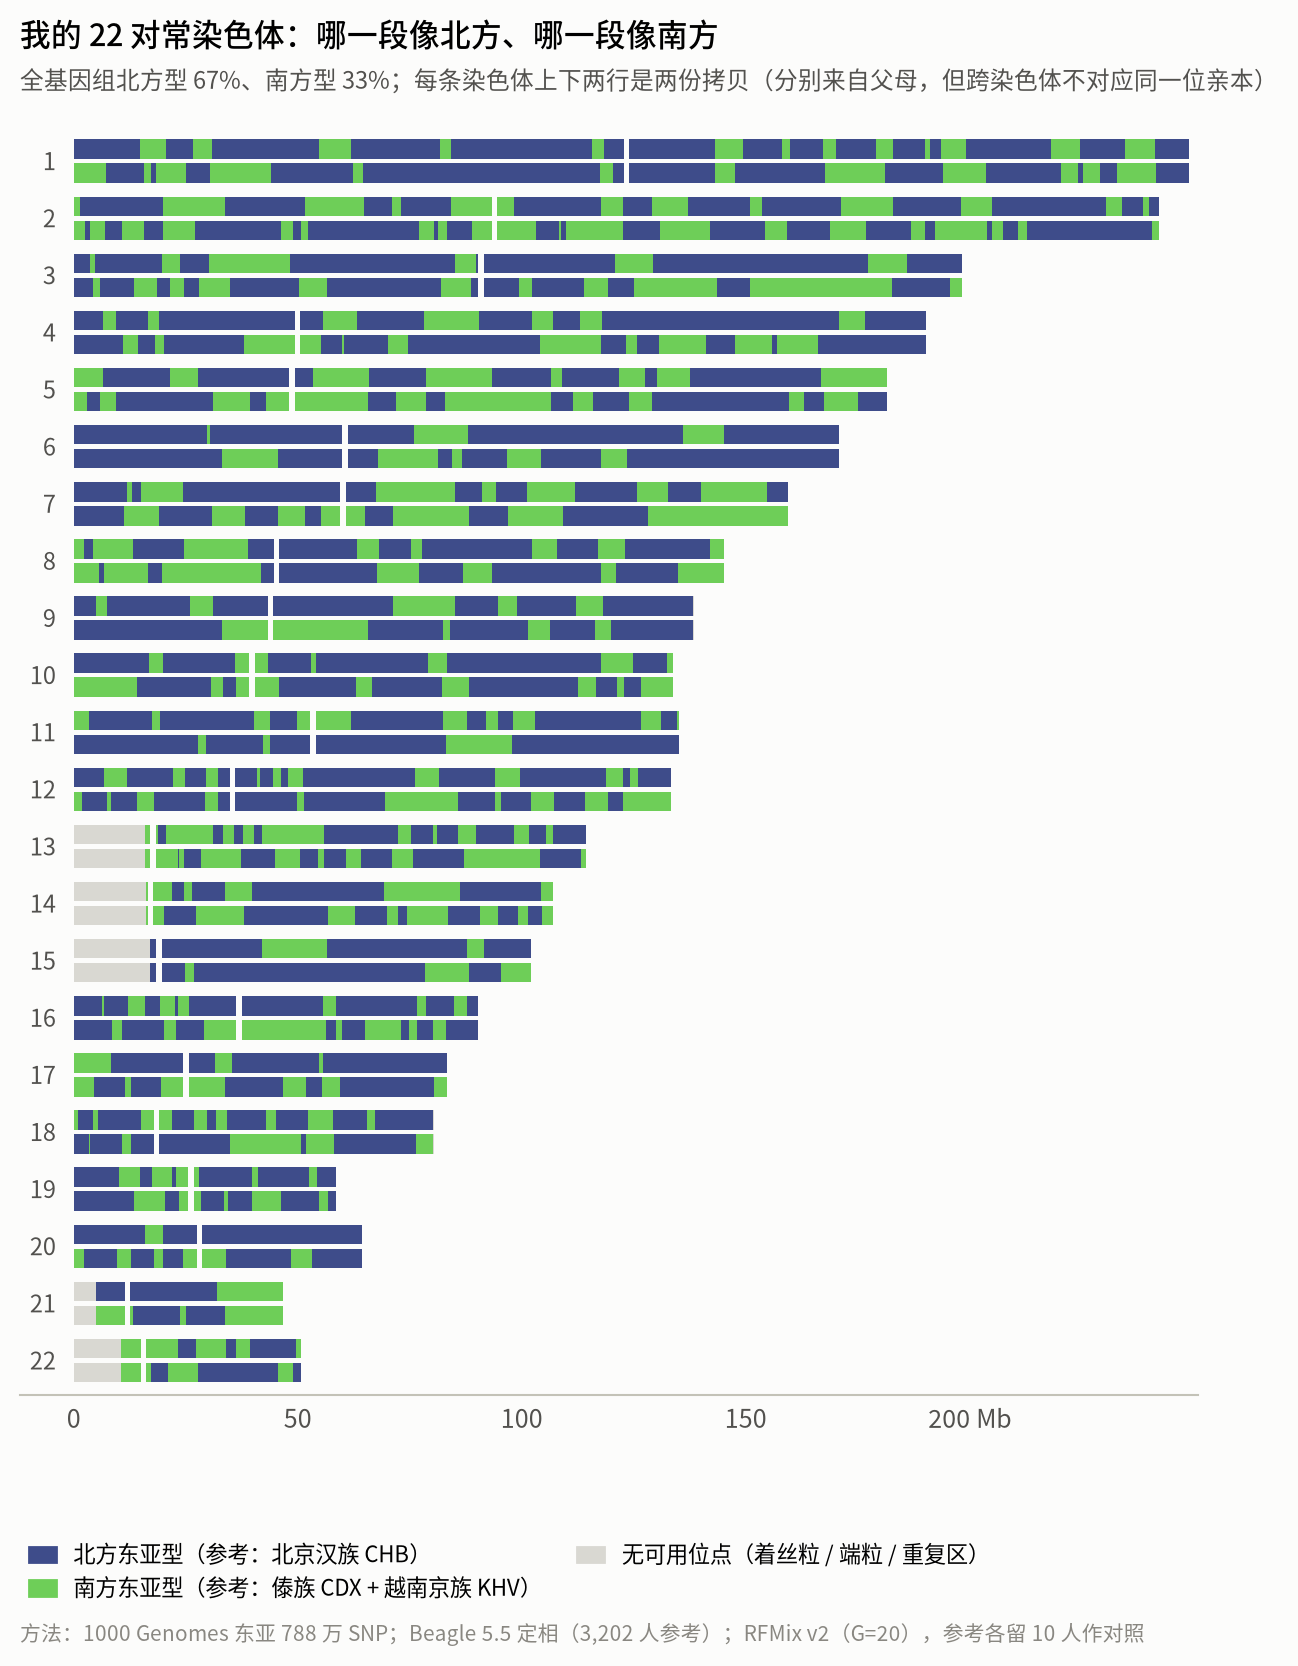
染色体涂色(局部祖源,RFMix):每条常染色体的两份拷贝逐段判为北方东亚型(像北京汉族)或南方东亚型(像傣族/京族)。全基因组:北方型 67%,南方型 33%。
| 染色体 | 北方型比例 |
|---|---|
| 1 | 73% |
| 2 | 62% |
| 3 | 66% |
| 4 | 71% |
| 5 | 56% |
| 6 | 81% |
| 7 | 51% |
| 8 | 61% |
| 9 | 73% |
| 10 | 73% |
| 11 | 79% |
| 12 | 69% |
| 13 | 51% |
| 14 | 59% |
| 15 | 78% |
| 16 | 65% |
| 17 | 73% |
| 18 | 68% |
| 19 | 67% |
| 20 | 80% |
| 21 | 55% |
| 22 | 50% |
每条染色体上下两行是两份拷贝(一份来自父亲、一份来自母亲;不同染色体之间对不上是哪位亲本)。整体上北方型约 67%、南方型约 33%,两种颜色细碎地交错说明几千年的通婚把我祖先的 DNA 切成了很短的片段。
为了进一步判断这样解读是否准确,我们用同样的方法给没参与训练的 1000 Genomes 个体打分(每组 10 人):
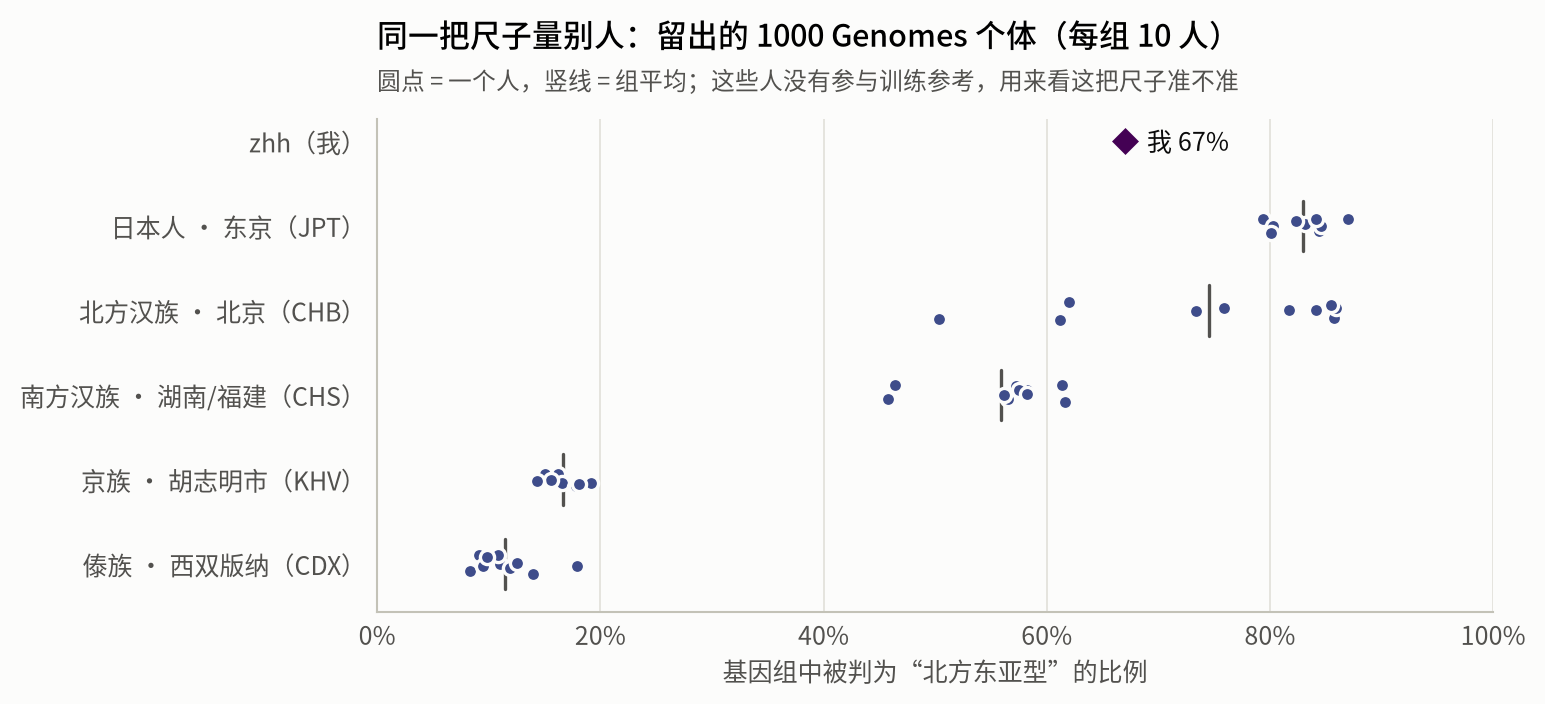
同一方法给留出的 1000 Genomes 个体打分(每组 10 人):
| 人群 | 北方型比例(中位数) |
|---|---|
| 北方汉族(北京) | 79% |
| 日本人 | 84% |
| 南方汉族 | 57% |
| 越南京族 | 16% |
| 傣族(西双版纳) | 11% |
| 我 | 67% |
北京汉族的中位数是 79%、日本人 84%、南方汉族 57%、越南京族 16%、傣族 11%。我是 67%,落在北京汉族和南方汉族之间,和主成分分析、qpAdm 的结论一致。东亚内部人群差异很小,单独一小段的判断误差不小,但是从整体比例看更为可靠。
方法:在 1000 Genomes 东亚人群中频率 ≥1% 的 788 万个 SNP 上读出我的基因型;Beagle 5.529 以 1000 Genomes 3,202 人45的已定相单倍型为参考定相;RFMix v230(混合代数 G=20)做局部祖源推断,参考为北京汉族约 90 人、傣族和京族约 170 人,另各留 10 人作对照。
父系与母系:两条单线#
- 父系(Y 染色体):O-M175 › O-M122 › O-M134 › O-Y20 › O-F79 › O-CTS10739 › O-MF1484(YFull 树64),在 FTDNA 树65上可再细分到 O-PH233。O-M134 是汉族最常见的父系大支之一。YFull 估计 O-MF1484 约在 7,400 年前从兄弟支系分出;这一支下数据库里的其他样本来自江苏和北京。
- 古 DNA 里的“同宗”:AADR 中有两位古人属于我的上游支 O-Y20:一位是约 6,000 年前河南邓州八里岗的仰韶文化男性66,另一位是约 2,300 年前的云南铁器时代个体67。O-Y20 本身有数千年历史,同属这一支不代表关系很近。
- 母系(线粒体):B4c1b2c。它下面的分支 B4c1b2c2 出现在约 3,900 年前青海喇家遗址(齐家文化)的个体身上46。她和我同属 B4c1b2c 这一支;再上一级的 B4c1b2 还见于 7 世纪匈牙利的阿瓦尔人68,69,属于一支从东亚草原西迁到欧洲的人群。
方法:Yleaf v4.1.533 同时用 YFull v14.01、FTDNA、ISOGG70 三棵树(结果一致,质量分 1.0);线粒体用 HaploGrep 334。古人单倍群取自 AADR 注释表。
我身上的尼安德特人和丹尼索瓦人#
如果再往前看时间线,走出非洲的现代人,基因组里都留着几万年前和尼安德特人、丹尼索瓦人通婚的痕迹。我找到 1,051 段古人类来源的片段,合计约 104 Mb;能判断来源的里面,尼安德特型约 80 Mb,丹尼索瓦型约 5.5 Mb(约占基因组的 0.1%,与东亚人的文献值吻合71)。尼安德特片段中,和克罗地亚文迪亚洞的尼安德特人最像的(270 段)多于和西伯利亚阿尔泰山区的两个尼安德特人最像的(阿尔泰、查格尔斯卡亚,各约 210 段)。以上也和“与现代人通婚的那支尼安德特人更接近文迪亚”的已知结论一致72。所以我一直认为我们的基因不是一张当前的照片,更像是一本流传万年的古书,记载了很多古时候的故事。
鼠标悬停可以看每段的位置、长度、与四个古人类基因组共享的变异数和覆盖的基因;右上角可以直接输入基因名查找。
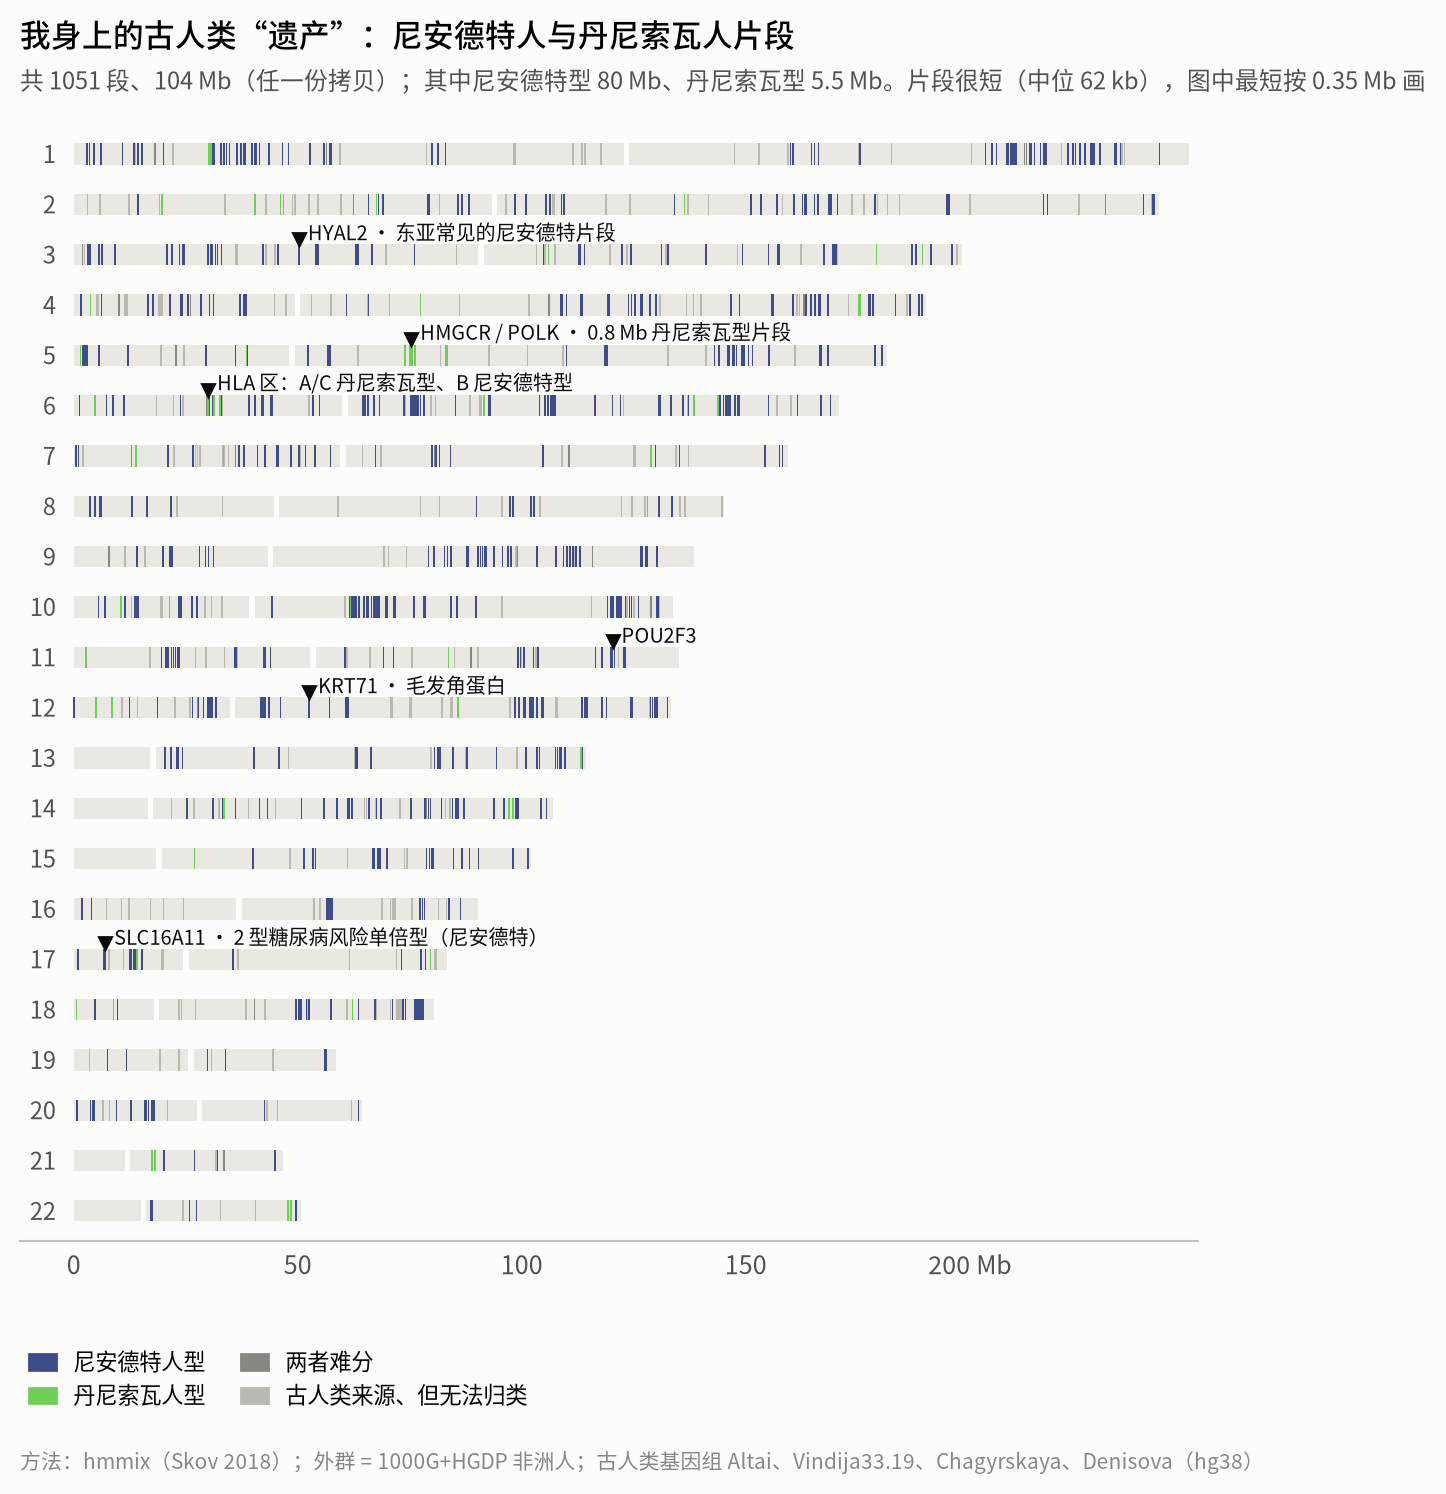
我的古人类片段(hmmix):共 1051 段、104 Mb;尼安德特型 80.4 Mb,丹尼索瓦型 5.5 Mb。值得一提的有 SLC16A11(2 型糖尿病风险单倍型,携带一份)、HLA 区、HYAL2、POU2F3、KRT71,以及 5 号染色体 HMGCR/POLK 附近 0.8 Mb 的丹尼索瓦型片段。
几个有故事的片段:
- SLC16A11(17 号染色体):一个著名的尼安德特单倍型,在东亚人群中的频率约 10%,每携带一份 2 型糖尿病风险约增加 25%73。我在这个单倍型的 4 个标记位点上都是杂合,说明只携带一份。
- HLA 区:HLA-A、HLA-C 附近被判为丹尼索瓦型,HLA-B 附近为尼安德特型。我恰好携带 HLA-A*11:01。有研究认为这个在东亚常见的 HLA 型最初来自丹尼索瓦人74。HLA 区多态性极高,当然这类判断只能当作线索。
- HYAL2、POU2F3:东亚人中常见、被认为可能是受过自然选择的尼安德特片段75,76;KRT71 毛发角蛋白基因上也有一段,角蛋白基因本来就是尼安德特片段的富集区76,77。
- 5 号染色体 HMGCR / POLK 附近 0.8 Mb 的丹尼索瓦型片段,是我身上最长的丹尼索瓦型片段;当前没查到针对这一段的专门研究,只当作一个有趣的记录。
这个量算多还是少?如果从 1000 Genomes 里抽了北方汉族、南方汉族、日本人、越南京族、傣族各 8 人,用完全相同的流程重算:
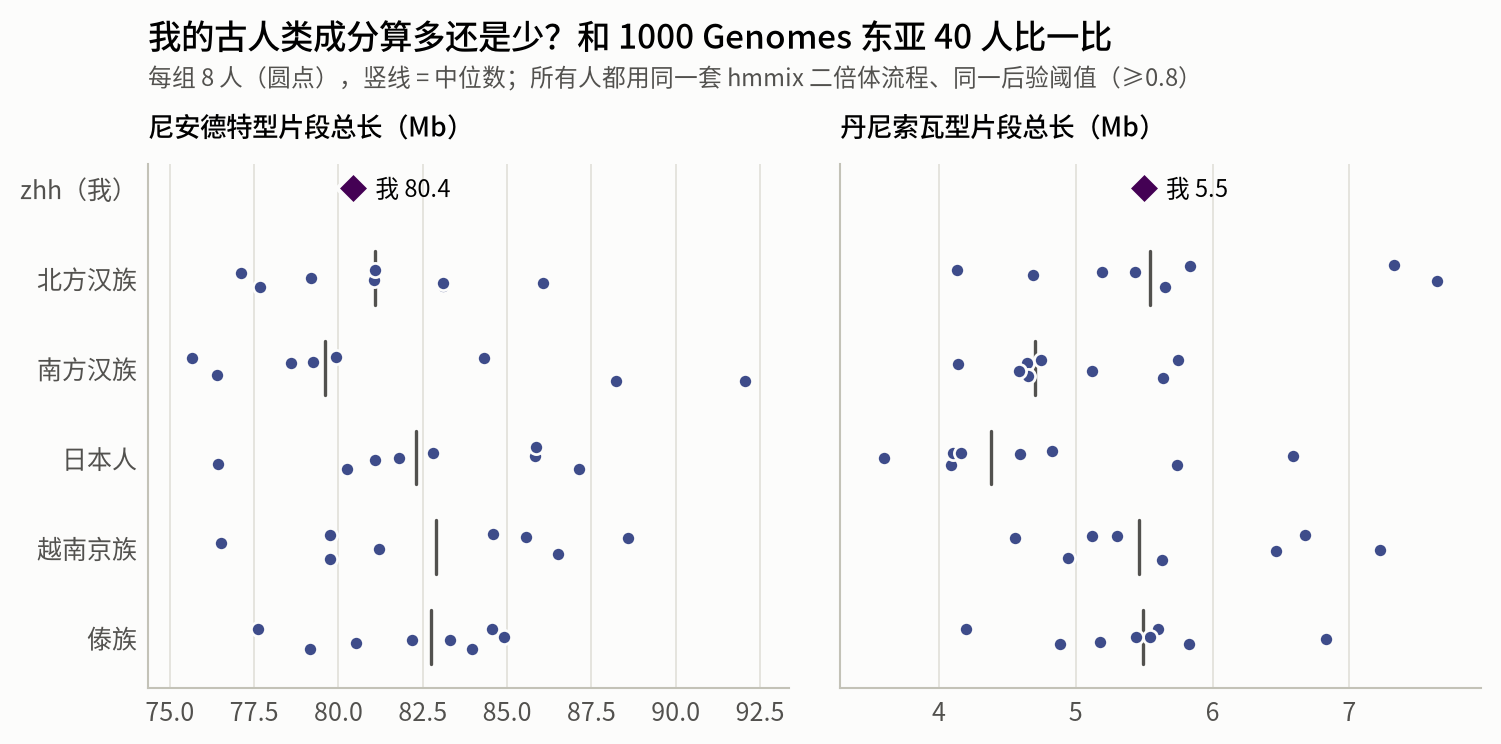
同一流程下,我与 1000 Genomes 东亚各 8 人的古人类成分对比(中位数):
| 人群 | 尼安德特型 Mb | 丹尼索瓦型 Mb |
|---|---|---|
| 北方汉族(北京) | 81.1 | 5.5 |
| 南方汉族 | 79.6 | 4.7 |
| 日本人 | 82.3 | 4.4 |
| 越南京族 | 82.9 | 5.5 |
| 傣族(西双版纳) | 82.7 | 5.5 |
| 我 | 80.4 | 5.5 |
我的尼安德特型 80 Mb 正好在中间,丹尼索瓦型 5.5 Mb 也在中间,说明我是一个“标准配置”的东亚人。
方法:hmmix31 二倍体解码,外群为 1000 Genomes + HGDP 的非洲人;用 4 个高覆盖古人类基因组(阿尔泰78、文迪亚72、查格尔斯卡亚79三个尼安德特人和丹尼索瓦人80)判断来源,后验概率 ≥ 0.8。片段内与尼安德特人共享的衍生变异多于丹尼索瓦人记为尼安德特型,反之为丹尼索瓦型。
父母有血缘关系吗#
如果父母是近亲,孩子的基因组里会出现很长的“两份拷贝一模一样”的片段(纯合片段,ROH)。
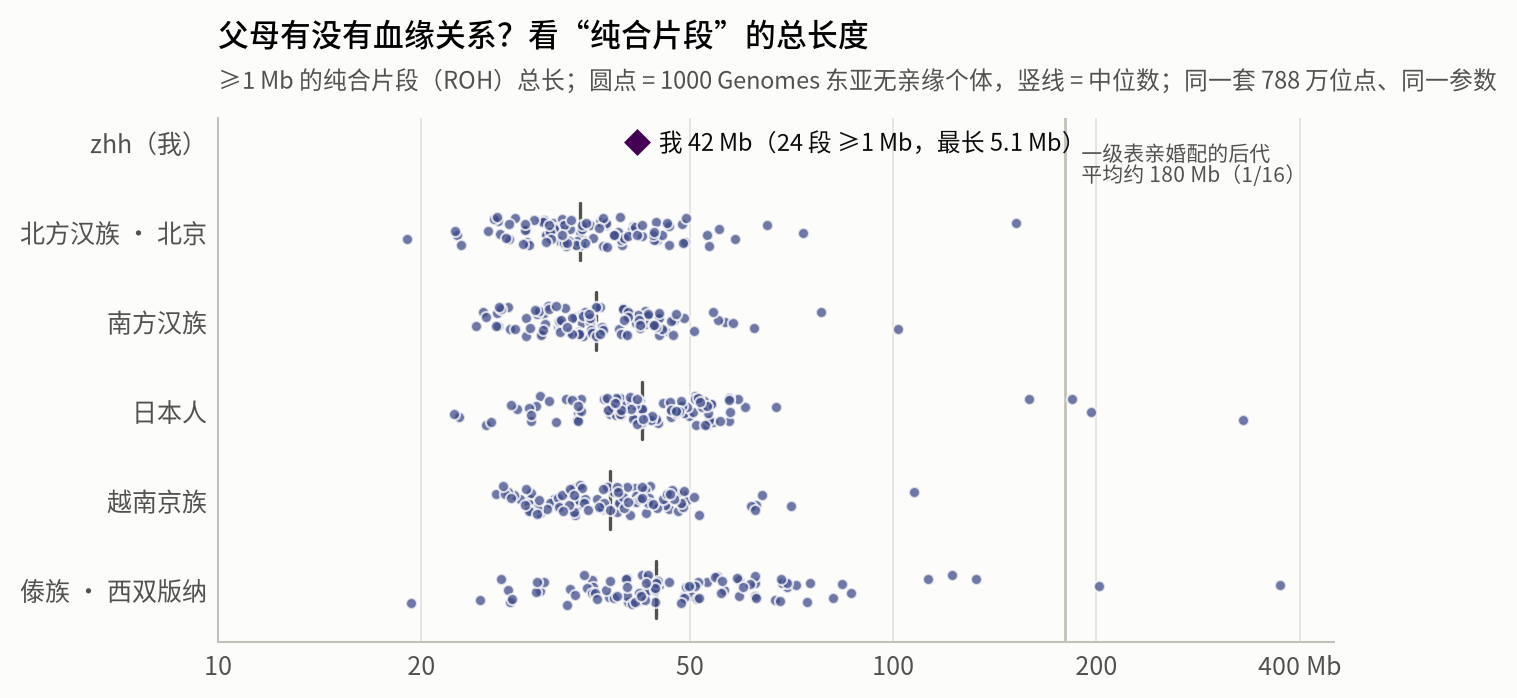
≥ 1 Mb 的纯合片段:我有 24 段、共 42 Mb,最长 5.1 Mb,在东亚人正常范围内;一级表亲婚配的后代平均约 180 Mb。
| 人群 | ROH 总长中位数 Mb |
|---|---|
| 北方汉族(北京) | 34 |
| 南方汉族 | 36 |
| 日本人 | 42 |
| 越南京族 | 38 |
| 傣族(西双版纳) | 44 |
我 ≥ 1 Mb 的纯合片段一共 24 段、42 Mb,最长 5.1 Mb,落在东亚人的正常范围中间;一级表亲婚配的后代平均会有约 180 Mb81。父母没有近亲关系。
方法:bcftools roh32,等位基因频率用 1000 Genomes 东亚人,遗传图谱用 Beagle 的 GRCh38 图谱;我和 506 个东亚对照用同一套 788 万个位点、同一参数。
五、年龄的分子痕迹#
我血液的 DNA 里也藏着一些和衰老有关的信号:
- 线粒体 DNA 拷贝数:每个血细胞里约 96 份,随年龄缓慢下降,也和健康状况有关82;不同方法测出来的绝对值差别很大,只适合自己跟自己比。
- 克隆性造血(CHIP):年纪增长后,部分造血干细胞会带着 DNMT3A、TET2 等基因的突变扩增成克隆,与血液肿瘤和心血管病风险相关83,84。我扫描了 25 个相关基因的编码区,唯一的候选(IDH2 上 3 个相邻位点)核查后是比对伪影:支持读段只有 2 条、都被大段截短。
- Y 染色体嵌合丢失:老年男性常见,与多种疾病相关85;在我这个年纪本来就罕见。
- 端粒长度:从读段里数 TTAGGG 重复估算35。绝对值受建库和测序平台影响很大,单次数字意义有限,更适合十年后用同一方法再测一次,看自己缩短了多少。
六、免疫与血液分型#
血型:不止 ABO 和 Rh#
医院验血只验 ABO 和 RhD,但红细胞表面有 40 多个血型系统。从基因组里能一次读出常见的十几个:
| 血型系统 | 我的类型 | 东亚人中常见吗 | 说明 |
|---|---|---|---|
| ABO | A 型(A/O) | 常见 | 由多个位点推断,以血清学检验为准 |
| Rh(D) | RhD 阳性(RHD 基因 2 份) | 汉族 99.5% 以上是阳性 | 也没有“亚洲型 DEL”变异 |
| Rh(E/e) | E+e+ | 常见 | C/c 因 RHD/RHCE 高度相似,短读长测不准 |
| Duffy | Fy(a+b−) | 约九成 | |
| Kidd | Jk(a+b+) | 约四到五成 | |
| Kell | K−k+ | 几乎全部 | K 抗原在东亚极罕见 |
| MNS | S−s+ | 约九成 | M/N 未分型(GYPA/GYPB 同源) |
| Diego | Di(a−b+) | 九成以上 | Di(a) 在东亚人中约 3–10%,是新生儿溶血的少见原因之一 |
| Lewis / 分泌型 | Le(a−b+),分泌型 | 常见 | FUT2、FUT3 都正常 |
| Dombrock / Colton / Yt / Lutheran / Junior | Do(a−b+)、Co(a+b−)、Yt(a+b−)、Lu(a−b+)、Jr(a+) | 都是常见型 | Jr(a−) 稀有血型在日本人中相对多见,我不是 |
总结:除了 ABO/Rh,我的其余血型都是东亚人最常见的类型,万一需要输血,不会有罕见血型的配血难题。
方法:每个血型系统取决定抗原的关键错义位点,用 Ensembl VEP18 确认“等位基因 → 氨基酸”,再按国际输血协会(ISBT)的抗原定义换算86;RHD 拷贝数用读段深度。ABO 在参考基因组上本身是 O 等位,需要特殊处理,结果为推断。
HLA 与 KIR:免疫系统的“身份证”和“读卡器”#
我们进行器官配型的时候一般要看免疫系统的类型。HLA 像细胞的“身份证”87(我的是 A*24:02/A*11:01、B*40:06/B*15:01、C*08:01/C*04:01),KIR 则是自然杀伤(NK)细胞上读身份证的“读卡器”。人群里 KIR 基因的有无差别很大,分 A、B 两类单倍型。
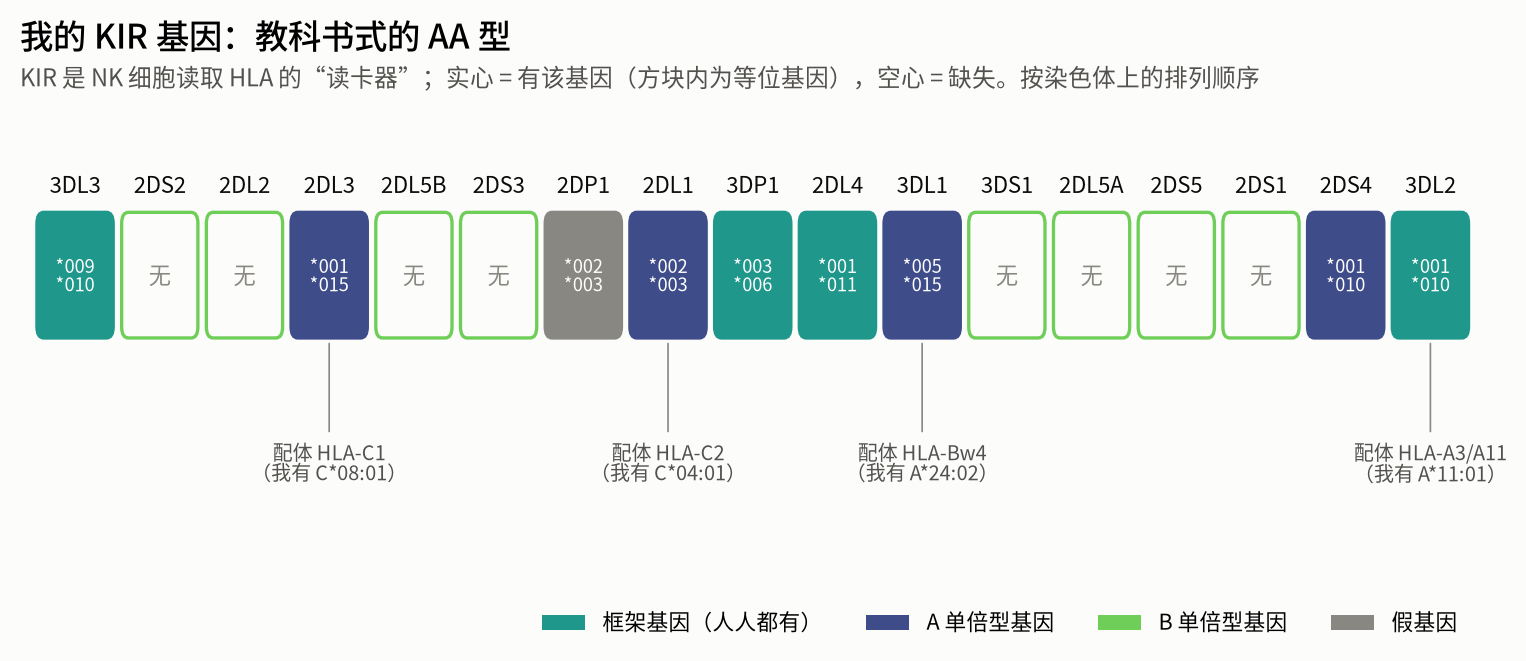
我的 KIR 基因有无(T1K 分型):AA 型,B 单倍型特有的激活型基因都没有。
| 基因 | 结果 |
|---|---|
| KIR2DL1 | KIR2DL1*003 / KIR2DL1*002 |
| KIR2DL2 | 缺失 |
| KIR2DL3 | KIR2DL3*015 / KIR2DL3*001 |
| KIR2DL4 | KIR2DL4*011 / KIR2DL4*001 |
| KIR2DL5A | 缺失 |
| KIR2DL5B | 缺失 |
| KIR2DP1 | KIR2DP1*003 / KIR2DP1*002 |
| KIR2DS1 | 缺失 |
| KIR2DS2 | 缺失 |
| KIR2DS3 | 缺失 |
| KIR2DS4 | KIR2DS4*001 / KIR2DS4*010 |
| KIR2DS5 | 缺失 |
| KIR3DL1 | KIR3DL1*005 / KIR3DL1*015 |
| KIR3DL2 | KIR3DL2*010 / KIR3DL2*001 |
| KIR3DL3 | KIR3DL3*010 / KIR3DL3*009 |
| KIR3DP1 | KIR3DP1*006 / KIR3DP1*003 |
| KIR3DS1 | 缺失 |
- 我是 AA 型:只带 A 单倍型的基因(2DL1、2DL3、2DS4、3DL1),B 单倍型特有的激活型基因(2DS1、2DS2、2DS3、2DS5、3DS1)都没有。AA 型在汉族中约占一半88。
- “读卡器”和“身份证”配得很齐:抑制性受体 KIR2DL1、KIR2DL3、KIR3DL1 都有对应的 HLA 配体(C*04:01 属 C2 组、C*08:01 属 C1 组、A*24:02 带 Bw4 表位),KIR3DL2 的配体 HLA-A*11 我也有。
- 用药相关的 HLA 风险型(卡马西平相关的 B*15:0289、别嘌醇相关的 B*58:0190 等)都没有。
方法:T1K36(kir-wgs 预设)+ 现场从 IPD-KIR91 构建的索引;HLA 同样用 T1K(IPD-IMGT/HLA 3.65.0)。KIR 是基因组里最难分型的区域之一,等位基因层面的结果仅供参考。
血液里的“非人类”DNA#
在我的 5.9 亿条读段里,有 107 万条(0.18%)比对不到人类参考基因组。这些读段的 GC 含量大多在 50%–80% 之间,而人类 DNA 平均只有约 41%,所以它们大多像细菌而不像人。《自私的基因》这本书很有意思地提了一个理念,认为基因才是主角,人只是其繁衍的载体92。当我们站在基因的角度去思考,很多行为都变得合理了,比如父母可以为了保护孩子而牺牲自己、工蜂终生不生育却甘愿为蜂后工作、虫草真菌感染蚂蚁后会改变蚂蚁的行为等等。所以很多其他物种的基因会想要整合到人体的基因组里,实现其扩大繁衍,这里最方便的就是病毒了。我们将我的这些“非人类”DNA 逐条分类:
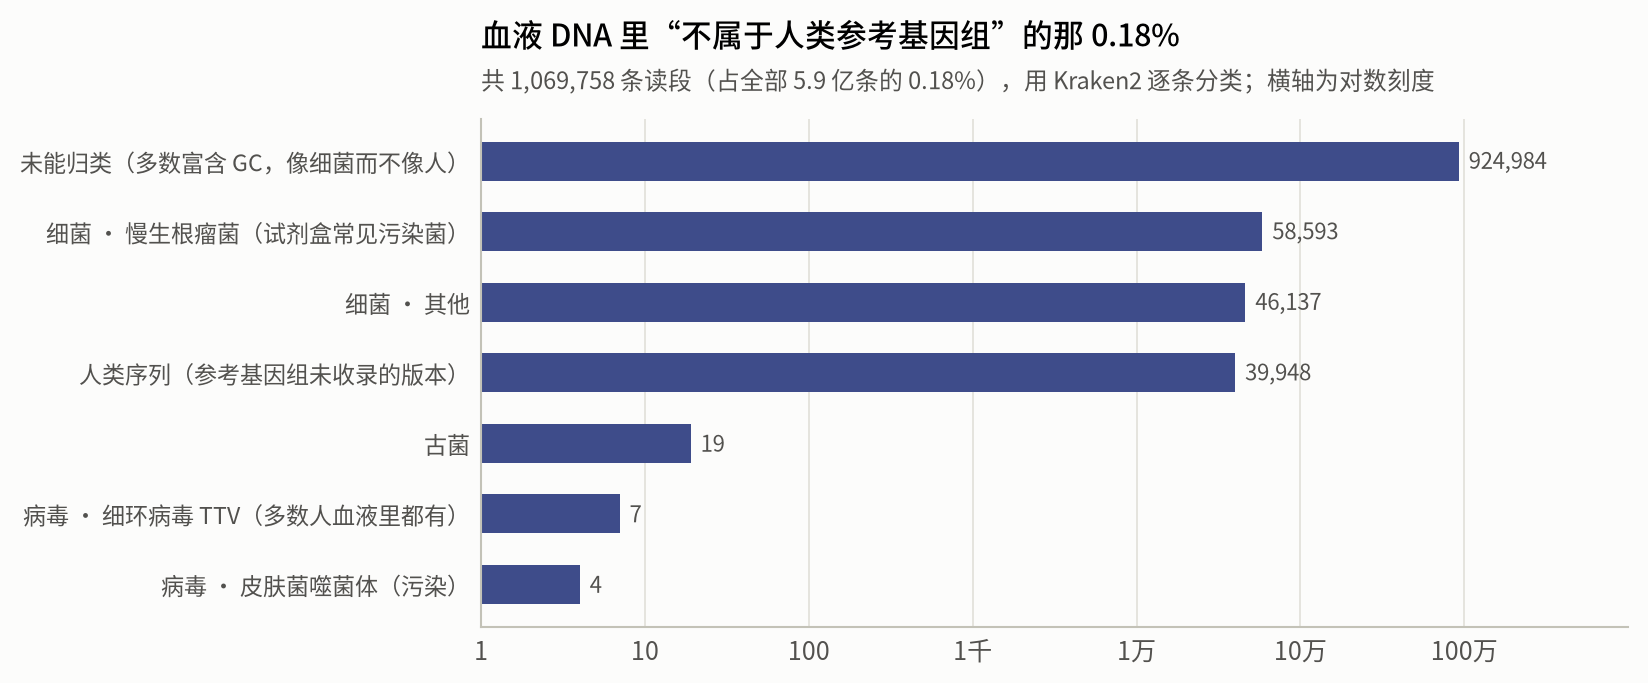
比对不到人类参考基因组的 1,069,758 条读段的分类(Kraken2):
| 类别 | 读段数 |
|---|---|
| 未能归类(多数富含 GC,像细菌而不像人) | 924,984 |
| 细菌 · 慢生根瘤菌(试剂盒常见污染菌) | 58,593 |
| 细菌 · 其他 | 46,137 |
| 人类序列(参考基因组未收录的版本) | 39,948 |
| 古菌 | 19 |
| 病毒 · 细环病毒 TTV(多数人血液里都有) | 7 |
| 病毒 · 皮肤菌噬菌体(污染) | 4 |
- 细菌读段里一半以上是慢生根瘤菌——测序试剂盒和超纯水里最常见的污染菌,不是我身上的93。
- 病毒只找到两类:7 条细环病毒(TTV)——九成以上的人血液里都有,被认为基本无害94;4 条皮肤菌的噬菌体(污染)。
- 没有检出乙肝病毒、HPV、HIV 等;也没有遗传性整合的 HHV-6(约 1% 的人天生在每个细胞里带一份 HHV-6 基因组,测序时会出现上万条读段95)。
- 最初以为有 51 条 EB 病毒读段,逐条核查发现全是人类读段的短片段假比对,并没有 EB 病毒的证据。
方法:未比对读段 + 原先比对到 EBV 诱饵序列的读段,用 Kraken237 2.17.2 和 standard-8GB 数据库(2026 年 6 月版)分类。血液 DNA 只能看到载量较高的病毒,“没检出”不等于没有感染。
七、拷贝数会变化的基因#
教科书说每个基因有两份,但有些基因在人群里本来就是“有人多、有人少、有人一份都没有”。点上方按钮切换基因,按住 Ctrl 滚轮可以放大:
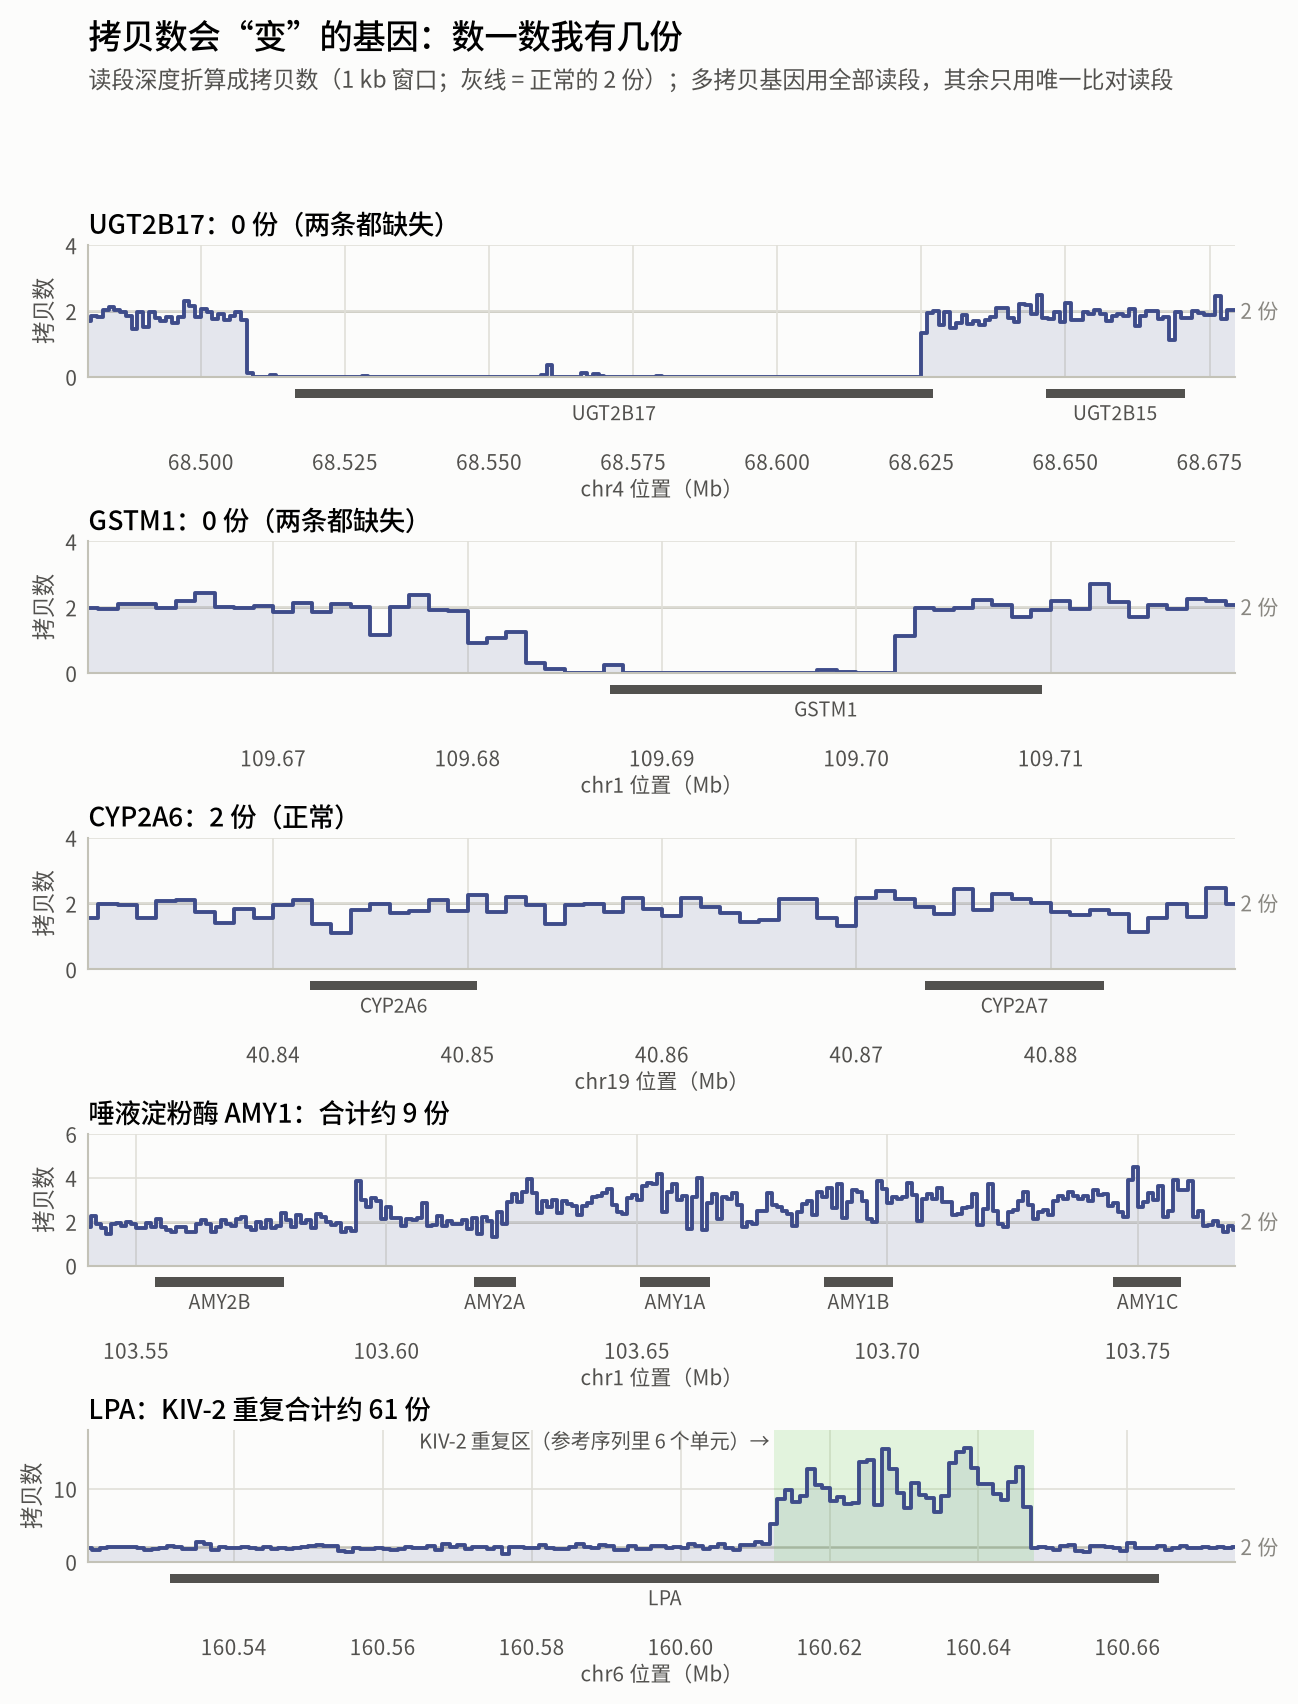
拷贝数会变化的基因(读段深度估计,约 ±10%):
| 基因 | 我有几份 |
|---|---|
| UGT2B17 | 0.0 |
| GSTM1 | 0.7 |
| CYP2A6 | 1.7 |
| AMY1 | 9.3 |
| C4 | 4.9 |
| RHD | 1.8 |
| 基因 | 我有几份 | 意味着什么 |
|---|---|---|
| UGT2B17 | 0(两条都缺失) | 东亚人中很常见。这个酶参与代谢睾酮等激素和一些药物;兴奋剂检测里的尿睾酮/表睾酮比值也会因此偏低96。 |
| GSTM1 | 0(两条都缺失) | 东亚约一半人如此。它是解毒酶,缺失与吸烟相关的部分风险有微弱关联。 |
| AMY1(唾液淀粉酶) | 约 9 份 | 人群中 2–17 份不等,以淀粉为主食的人群平均更多97。 |
| LPA 的 KIV-2 重复 | 约 61 份(两条合计) | 重复越多,脂蛋白(a) 颗粒越大、血中浓度通常越低。Lp(a) 是独立的心血管风险因素,主要由基因决定;我的重复数偏多,提示 Lp(a) 大概率不高——它最好直接抽血测一次(一生测一次就够)98。 |
| CYP2A6 | 2 份 | 没有东亚常见的整基因缺失(会让尼古丁代谢变慢)。 |
| C4 补体 | 约 5 份 | 多数人是 4 份99。 |
方法:拷贝数 = 2 × 区域平均深度 ÷ 常染色体平均深度(同一过滤条件)。多拷贝/高同源基因(AMY1、C4、LPA KIV-2)用全部读段并把参考序列里的各拷贝加总;单拷贝基因只用唯一比对读段。深度法的绝对值大约有 ±10% 的误差。
八、可干预疾病与用药的位点#
这里有些经常作为筛查的基因位点:
- ACMG 推荐的 84 个“可提前干预”基因25(遗传性肿瘤、心肌病/心律失常、家族性高胆固醇血症、马凡综合征等)里没有发现致病或可能致病变异。没发现不等于零风险,但至少没有已知的高风险变异。
- APOE 是 ε3/ε3,最常见的类型,阿尔茨海默病风险处于人群平均水平。
隐性病携带的结果具有更多隐私信息,这里不继续展开。
用药相关的基因#
药物基因组是全基因组测序里最有用的部分。按 CPIC/DPWG 指南39,100,用 PharmCAT38 分型、CYP2D6 另用 Cyrius101:
| 基因 | 我的表型 | 影响的药 | 实际意义 |
|---|---|---|---|
| CYP2C19 | 中间代谢(*1/*2) | 氯吡格雷、PPI、部分抗抑郁药 | 放支架或卒中后抗血小板时,氯吡格雷效果可能打折 |
| CYP2D6 | 中间代谢(*10/*36+*10) | 可待因、曲马多、他莫昔芬 | 这类止痛药可能效果偏弱 |
| VKORC1 | 敏感(−1639 A/A) | 华法林 | 需要的剂量比欧美标准低,东亚人多数如此 |
| ABCG2 | 功能下降(Q141K 杂合) | 瑞舒伐他汀、别嘌醇 | 瑞舒伐他汀血药浓度偏高,起始量宜小 |
| CYP3A5 | 中间代谢 | 他克莫司 | 器官移植时起始剂量需要调整 |
| CYP2B6 | 中间代谢 | 依非韦伦、美沙酮 | |
| NAT2 | 快乙酰化 | 异烟肼 | 抗结核药肝毒性风险相对低 |
| 其余 | 正常 | DPYD、TPMT、NUDT15、UGT1A1、G6PD、SLCO1B1、CYP2C9 等 | 按常规剂量 |
九、多基因风险评分#
当我们把成百上千个“小效应”变异加起来,可以估计某种病的“基因背景”在人群中的位置。我用基于东亚或中国人群开发的评分系统(来自 PGS Catalog40,用 PLINK 241 计算),与 1000 Genomes 东亚 585 人比:
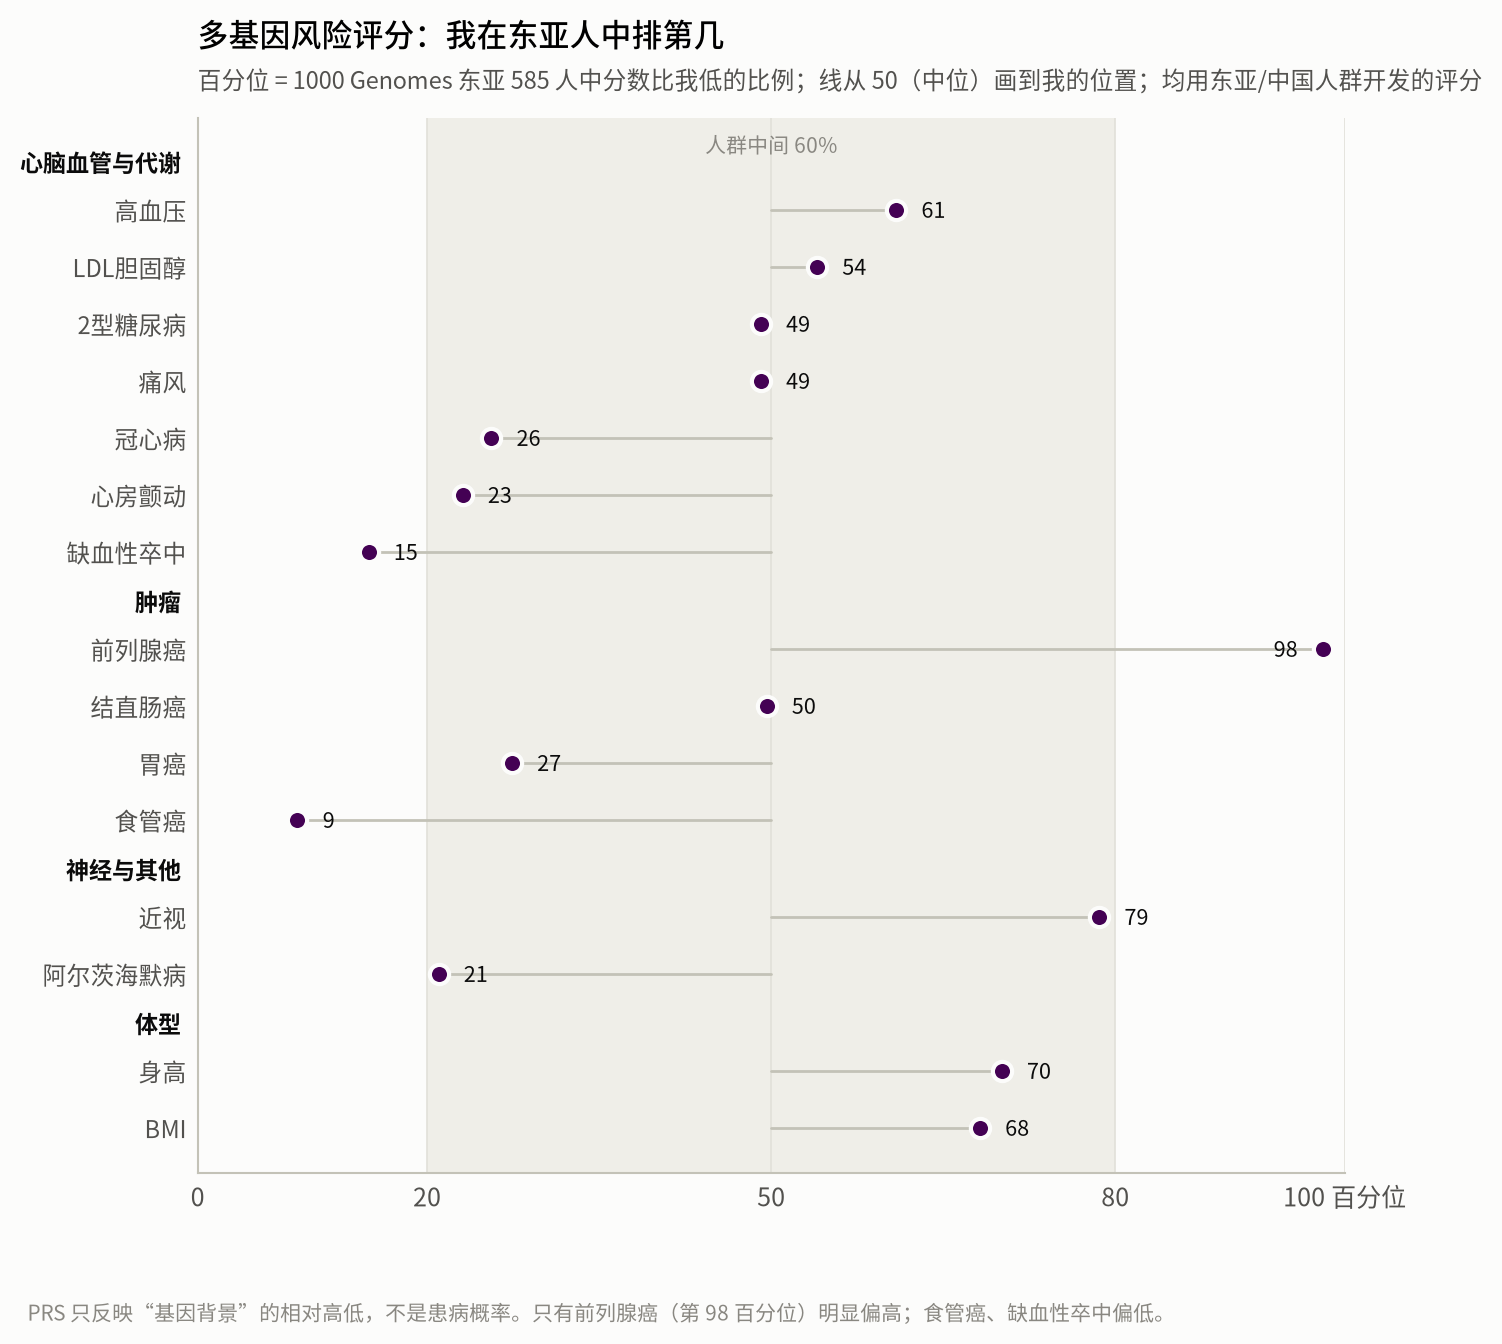
多基因风险评分在 1000 Genomes 东亚 585 人中的百分位(相对位置,不是患病概率):
| 性状 | 百分位 | PGS | 来源 |
|---|---|---|---|
| 前列腺癌 | 98 | PGS018563 | TPMI 2025 PRS-CS(台湾汉族) |
| 近视 | 79 | PGS019957 | Lin 2024 prs149_myopia |
| 身高 | 70 | PGS002803 | Yengo 2022 GIANT EAS weights |
| BMI | 68 | PGS012556 | Xu 2026 BMI_EAS_MIXPRSplus |
| 高血压 | 61 | PGS005144 | Jung 2025 PRS-CS EAS |
| LDL胆固醇 | 54 | PGS004643 | Zhang 2024 LDL_EAS_ldpred2 |
| 结直肠癌 | 50 | PGS002742 | Ping 2022 PRS115_EAS |
| 2型糖尿病 | 49 | PGS005365 | Huerta-Chagoya 2025 DPRISM trained for EAS |
| 痛风 | 49 | PGS018825 | TPMI 2025 PRS-CS(台湾汉族) |
| 胃癌 | 27 | PGS005161 | Zhu 2025 PRS-GC(中国人群) |
| 冠心病 | 26 | PGS004941 | China Kadoorie Biobank 2024 CAD_MetaPRS(中国人群开发验证) |
| 心房颤动 | 23 | PGS012536 | Haydarlou 2026 Mult-t-EAS |
| 阿尔茨海默病 | 21 | PGS004589 | Jung 2022 PRS80_trans(APOE 另行单独报告) |
| 缺血性卒中 | 15 | PGS002725 | GIGASTROKE 2022 iPGS_EAS |
| 食管癌 | 9 | PGS018478 | TPMI 2025 PRS-CS(台湾汉族) |
只有前列腺癌(第 98 百分位)明显偏高;食管癌、缺血性卒中偏低,其余在人群主体范围内。多基因评分反映的是相对位置,不是患病概率:前列腺癌的基础发病率本来不高,第 98 百分位意味着到了年纪更值得按时做 PSA 筛查,而不是“会得病”。
十、神经肌肉病相关的重复扩增#
神经肌肉病是我的老本行,所以对重复扩增类疾病格外留意。重复数用 ExpansionHunter42 从读段估计。51 个已知致病重复位点102(强直性肌营养不良 1/2 型、眼咽型肌营养不良、神经元核内包涵体病、OPDM、CANVAS、SCA27B、亨廷顿病、多种脊髓小脑共济失调等)都没有致病性扩增。
唯一的“异常”是 RFC1:一个等位约 72 个重复,超过了正常上限。但直接看完整覆盖重复区的读段,扩增单元是 AAAGG,属于人群里常见的良性多态,不是导致 CANVAS 的 AAGGG103。无临床意义。
十一、WGS 自我分析 skill#
WGS 可以提供很多信息,可以看基因的历史(人种起源),也可以看基因的现在(药物代谢位点),还有预测基因的未来(癌症风险预测),以上分析流程整理为了一个 skill,把此链接复制给 AI 让其生成自己的基因报告。
工具与数据:Parabricks 4.7(fq2bam、DeepVariant)13,16、GLnexus17、samtools / bcftools104、mosdepth5、Picard6、VEP 11618 + SpliceAI23、ExpansionHunter42、T1K36、Cyrius101、PharmCAT38、PLINK 241、AADR v66.p128、ADMIXTOOLS27、EIGENSOFT26、Beagle 5.529、RFMix v230、hmmix31、bcftools roh32、Yleaf33、HaploGrep 334、Kraken237、TelSeq35;参考基因组 GRCh38 no-alt + hs38d112;参考人群 1000 Genomes44,45、HGDP43、SGDP53。图表用 ECharts105,统一 viridis 色板。
参考文献#
- Bentley DR, Balasubramanian S, Swerdlow HP, et al. Accurate whole human genome sequencing using reversible terminator chemistry. Nature. 2008;456(7218):53–59. https://doi.org/10.1038/nature07517
- Illumina. NovaSeq X Series specifications. https://www.illumina.com/systems/sequencing-platforms/novaseq-x-plus/specifications.html
- Illumina. Chemistry and imaging on the NovaSeq X Series instruments. https://knowledge.illumina.com/instrumentation/novaseq-x-x-plus/instrumentation-novaseq-x-x-plus-reference_material-list/000007970
- Ewing B, Green P. Base-Calling of Automated Sequencer Traces Using Phred. II. Error Probabilities. Genome Res. 1998;8(3):186–194. https://doi.org/10.1101/gr.8.3.186
- Pedersen BS, Quinlan AR. Mosdepth: quick coverage calculation for genomes and exomes. Bioinformatics. 2018;34(5):867–868. https://doi.org/10.1093/bioinformatics/btx699
- Broad Institute. Picard toolkit: MarkDuplicates. https://broadinstitute.github.io/picard/
- Zhang F, Flickinger M, Taliun SAG, et al. Ancestry-agnostic estimation of DNA sample contamination from sequence reads. Genome Res. 2020;30(2):185–194. https://doi.org/10.1101/gr.246934.118
- Cock PJA, Fields CJ, Goto N, et al. The Sanger FASTQ file format for sequences with quality scores, and the Solexa/Illumina FASTQ variants. Nucleic Acids Res. 2010;38(6):1767–1771. https://doi.org/10.1093/nar/gkp1137
- Li H, Handsaker B, Wysoker A, et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 2009;25(16):2078–2079. https://doi.org/10.1093/bioinformatics/btp352
- Bonfield JK. CRAM 3.1: advances in the CRAM file format. Bioinformatics. 2022;38(6):1497–1503. https://doi.org/10.1093/bioinformatics/btac010
- Danecek P, Auton A, Abecasis G, et al. The variant call format and VCFtools. Bioinformatics. 2011;27(15):2156–2158. https://doi.org/10.1093/bioinformatics/btr330
- Schneider VA, Graves-Lindsay T, Howe K, et al. Evaluation of GRCh38 and de novo haploid genome assemblies demonstrates the enduring quality of the reference assembly. Genome Res. 2017;27(5):849–864. https://doi.org/10.1101/gr.213611.116
- NVIDIA. Clara Parabricks 4.7 documentation: fq2bam, DeepVariant. https://docs.nvidia.com/clara/parabricks/
- Li H, Durbin R. Fast and accurate short read alignment with Burrows–Wheeler transform. Bioinformatics. 2009;25(14):1754–1760. https://doi.org/10.1093/bioinformatics/btp324
- Li H. Aligning sequence reads, clone sequences and assembly contigs with BWA-MEM. arXiv. 2013:1303.3997. https://arxiv.org/abs/1303.3997
- Poplin R, Chang PC, Alexander D, et al. A universal SNP and small-indel variant caller using deep neural networks. Nat Biotechnol. 2018;36(10):983–987. https://doi.org/10.1038/nbt.4235
- Yun T, Li H, Chang PC, et al. Accurate, scalable cohort variant calls using DeepVariant and GLnexus. Bioinformatics. 2021;36(24):5582–5589. https://doi.org/10.1093/bioinformatics/btaa1081
- McLaren W, Gil L, Hunt SE, et al. The Ensembl Variant Effect Predictor. Genome Biol. 2016;17(1):122. https://doi.org/10.1186/s13059-016-0974-4
- Karczewski KJ, Francioli LC, Tiao G, et al. The mutational constraint spectrum quantified from variation in 141,456 humans. Nature. 2020;581(7809):434–443. https://doi.org/10.1038/s41586-020-2308-7
- Landrum MJ, Lee JM, Benson M, et al. ClinVar: improving access to variant interpretations and supporting evidence. Nucleic Acids Res. 2018;46(D1):D1062–D1067. https://doi.org/10.1093/nar/gkx1153
- Ioannidis NM, Rothstein JH, Pejaver V, et al. REVEL: An Ensemble Method for Predicting the Pathogenicity of Rare Missense Variants. Am J Hum Genet. 2016;99(4):877–885. https://doi.org/10.1016/j.ajhg.2016.08.016
- Cheng J, Novati G, Pan J, et al. Accurate proteome-wide missense variant effect prediction with AlphaMissense. Science. 2023;381(6664):eadg7492. https://doi.org/10.1126/science.adg7492
- Jaganathan K, Kyriazopoulou Panagiotopoulou S, McRae JF, et al. Predicting Splicing from Primary Sequence with Deep Learning. Cell. 2019;176(3):535–548.e24. https://doi.org/10.1016/j.cell.2018.12.015
- Richards S, Aziz N, Bale S, et al. Standards and guidelines for the interpretation of sequence variants: a joint consensus recommendation of the American College of Medical Genetics and Genomics and the Association for Molecular Pathology. Genet Med. 2015;17(5):405–424. https://doi.org/10.1038/gim.2015.30
- Lee K, Abul-Husn NS, Amendola LM, et al. ACMG SF v3.3 list for reporting of secondary findings in clinical exome and genome sequencing: A policy statement of the American College of Medical Genetics and Genomics (ACMG). Genet Med. 2025;27(8):101454. https://doi.org/10.1016/j.gim.2025.101454
- Patterson N, Price AL, Reich D. Population Structure and Eigenanalysis. PLoS Genet. 2006;2(12):e190. https://doi.org/10.1371/journal.pgen.0020190
- Patterson N, Moorjani P, Luo Y, et al. Ancient Admixture in Human History. Genetics. 2012;192(3):1065–1093. https://doi.org/10.1534/genetics.112.145037
- Mallick S, Micco A, Mah M, et al. The Allen Ancient DNA Resource (AADR) a curated compendium of ancient human genomes. Sci Data. 2024;11(1):182. https://doi.org/10.1038/s41597-024-03031-7
- Browning BL, Tian X, Zhou Y, et al. Fast two-stage phasing of large-scale sequence data. Am J Hum Genet. 2021;108(10):1880–1890. https://doi.org/10.1016/j.ajhg.2021.08.005
- Maples BK, Gravel S, Kenny EE, et al. RFMix: A Discriminative Modeling Approach for Rapid and Robust Local-Ancestry Inference. Am J Hum Genet. 2013;93(2):278–288. https://doi.org/10.1016/j.ajhg.2013.06.020
- Skov L, Hui R, Shchur V, et al. Detecting archaic introgression using an unadmixed outgroup. PLoS Genet. 2018;14(9):e1007641. https://doi.org/10.1371/journal.pgen.1007641
- Narasimhan V, Danecek P, Scally A, et al. BCFtools/RoH: a hidden Markov model approach for detecting autozygosity from next-generation sequencing data. Bioinformatics. 2016;32(11):1749–1751. https://doi.org/10.1093/bioinformatics/btw044
- Ralf A, Montiel González D, Zhong K, et al. Yleaf: Software for Human Y-Chromosomal Haplogroup Inference from Next-Generation Sequencing Data. Mol Biol Evol. 2018;35(5):1291–1294. https://doi.org/10.1093/molbev/msy032
- Schönherr S, Weissensteiner H, Kronenberg F, et al. Haplogrep 3 - an interactive haplogroup classification and analysis platform. Nucleic Acids Res. 2023;51(W1):W263–W268. https://doi.org/10.1093/nar/gkad284
- Ding Z, Mangino M, Aviv A, et al. Estimating telomere length from whole genome sequence data. Nucleic Acids Res. 2014;42(9):e75. https://doi.org/10.1093/nar/gku181
- Song L, Bai G, Liu XS, et al. Efficient and accurate KIR and HLA genotyping with massively parallel sequencing data. Genome Res. 2023;33(6):923–931. https://doi.org/10.1101/gr.277585.122
- Wood DE, Lu J, Langmead B. Improved metagenomic analysis with Kraken 2. Genome Biol. 2019;20(1):257. https://doi.org/10.1186/s13059-019-1891-0
- Sangkuhl K, Whirl‐Carrillo M, Whaley RM, et al. Pharmacogenomics Clinical Annotation Tool (PharmCAT). Clin Pharmacol Ther. 2020;107(1):203–210. https://doi.org/10.1002/cpt.1568
- Relling MV, Klein TE. CPIC: Clinical Pharmacogenetics Implementation Consortium of the Pharmacogenomics Research Network. Clin Pharmacol Ther. 2011;89(3):464–467. https://doi.org/10.1038/clpt.2010.279
- Lambert SA, Gil L, Jupp S, et al. The Polygenic Score Catalog as an open database for reproducibility and systematic evaluation. Nat Genet. 2021;53(4):420–425. https://doi.org/10.1038/s41588-021-00783-5
- Chang CC, Chow CC, Tellier LC, et al. Second-generation PLINK: rising to the challenge of larger and richer datasets. GigaScience. 2015;4:7. https://doi.org/10.1186/s13742-015-0047-8
- Dolzhenko E, Deshpande V, Schlesinger F, et al. ExpansionHunter: a sequence-graph-based tool to analyze variation in short tandem repeat regions. Bioinformatics. 2019;35(22):4754–4756. https://doi.org/10.1093/bioinformatics/btz431
- Bergström A, McCarthy SA, Hui R, et al. Insights into human genetic variation and population history from 929 diverse genomes. Science. 2020;367(6484):eaay5012. https://doi.org/10.1126/science.aay5012
- The 1000 Genomes Project Consortium. A global reference for human genetic variation. Nature. 2015;526(7571):68–74. https://doi.org/10.1038/nature15393
- Byrska-Bishop M, Evani US, Zhao X, et al. High-coverage whole-genome sequencing of the expanded 1000 Genomes Project cohort including 602 trios. Cell. 2022;185(18):3426–3440.e19. https://doi.org/10.1016/j.cell.2022.08.004
- Ning C, Li T, Wang K, et al. Ancient genomes from northern China suggest links between subsistence changes and human migration. Nat Commun. 2020;11(1):2700. https://doi.org/10.1038/s41467-020-16557-2
- Wang CC, Yeh HY, Popov AN, et al. Genomic insights into the formation of human populations in East Asia. Nature. 2021;591(7850):413–419. https://doi.org/10.1038/s41586-021-03336-2
- Fang H, Liang F, Ma H, et al. Dynamic history of the Central Plain and Haidai region inferred from Late Neolithic to Iron Age ancient human genomes. Cell Rep. 2025;44(2):115262. https://doi.org/10.1016/j.celrep.2025.115262
- Jeong C, Wang K, Wilkin S, et al. A Dynamic 6,000-Year Genetic History of Eurasia’s Eastern Steppe. Cell. 2020;183(4):890–904.e29. https://doi.org/10.1016/j.cell.2020.10.015
- Haak W, Lazaridis I, Patterson N, et al. Massive migration from the steppe was a source for Indo-European languages in Europe. Nature. 2015;522(7555):207–211. https://doi.org/10.1038/nature14317
- Harney É, Patterson N, Reich D, et al. Assessing the performance of qpAdm: a statistical tool for studying population admixture. Genetics. 2021;217(4):iyaa045. https://doi.org/10.1093/genetics/iyaa045
- Yang MA, Fan X, Sun B, et al. Ancient DNA indicates human population shifts and admixture in northern and southern China. Science. 2020;369(6501):282–288. https://doi.org/10.1126/science.aba0909
- Mallick S, Li H, Lipson M, et al. The Simons Genome Diversity Project: 300 genomes from 142 diverse populations. Nature. 2016;538(7624):201–206. https://doi.org/10.1038/nature18964
- Fu Q, Li H, Moorjani P, et al. Genome sequence of a 45,000-year-old modern human from western Siberia. Nature. 2014;514(7523):445–449. https://doi.org/10.1038/nature13810
- Seguin-Orlando A, Korneliussen TS, Sikora M, et al. Genomic structure in Europeans dating back at least 36,200 years. Science. 2014;346(6213):1113–1118. https://doi.org/10.1126/science.aaa0114
- Mondal M, Casals F, Xu T, et al. Genomic analysis of Andamanese provides insights into ancient human migration into Asia and adaptation. Nat Genet. 2016;48(9):1066–1070. https://doi.org/10.1038/ng.3621
- Yang MA, Gao X, Theunert C, et al. 40,000-Year-Old Individual from Asia Provides Insight into Early Population Structure in Eurasia. Curr Biol. 2017;27(20):3202–3208.e9. https://doi.org/10.1016/j.cub.2017.09.030
- Lazaridis I, Nadel D, Rollefson G, et al. Genomic insights into the origin of farming in the ancient Near East. Nature. 2016;536(7617):419–424. https://doi.org/10.1038/nature19310
- Cooke NP, Mattiangeli V, Cassidy LM, et al. Ancient genomics reveals tripartite origins of Japanese populations. Sci Adv. 2021;7(38):eabh2419. https://doi.org/10.1126/sciadv.abh2419
- Mao X, Zhang H, Qiao S, et al. The deep population history of northern East Asia from the Late Pleistocene to the Holocene. Cell. 2021;184(12):3256–3266.e13. https://doi.org/10.1016/j.cell.2021.04.040
- Sikora M, Pitulko VV, Sousa VC, et al. The population history of northeastern Siberia since the Pleistocene. Nature. 2019;570(7760):182–188. https://doi.org/10.1038/s41586-019-1279-z
- Wang T, Wang W, Xie G, et al. Human population history at the crossroads of East and Southeast Asia since 11,000 years ago. Cell. 2021;184(14):3829–3841.e21. https://doi.org/10.1016/j.cell.2021.05.018
- Liu J, Liu Y, Zhao Y, et al. East Asian Gene flow bridged by northern coastal populations over past 6000 years. Nat Commun. 2025;16(1):1322. https://doi.org/10.1038/s41467-025-56555-w
- YFull. YTree v14.01: O-MF1484. https://www.yfull.com/tree/O-MF1484/
- FamilyTreeDNA. Y-DNA Haplotree. https://discover.familytreedna.com/
- Yang T, He J, Li C, et al. Ancient DNA reveals the population interactions and a Neolithic patrilineal community in Northern Yangtze Region. Nat Commun. 2025;16(1):8728. https://doi.org/10.1038/s41467-025-63743-1
- Wang T, Yang MA, Zhu Z, et al. Prehistoric genomes from Yunnan reveal ancestry related to Tibetans and Austroasiatic speakers. Science. 2025;388(6750):eadq9792. https://doi.org/10.1126/science.adq9792
- Maróti Z, Neparáczki E, Schütz O, et al. The genetic origin of Huns, Avars, and conquering Hungarians. Curr Biol. 2022;32(13):2858–2870.e7. https://doi.org/10.1016/j.cub.2022.04.093
- Gnecchi-Ruscone GA, Rácz Z, Samu L, et al. Network of large pedigrees reveals social practices of Avar communities. Nature. 2024;629(8011):376–383. https://doi.org/10.1038/s41586-024-07312-4
- International Society of Genetic Genealogy. ISOGG Y-DNA Haplogroup Tree. https://isogg.org/tree/
- Sankararaman S, Mallick S, Patterson N, et al. The Combined Landscape of Denisovan and Neanderthal Ancestry in Present-Day Humans. Curr Biol. 2016;26(9):1241–1247. https://doi.org/10.1016/j.cub.2016.03.037
- Prüfer K, de Filippo C, Grote S, et al. A high-coverage Neandertal genome from Vindija Cave in Croatia. Science. 2017;358(6363):655–658. https://doi.org/10.1126/science.aao1887
- The SIGMA Type 2 Diabetes Consortium. Sequence variants in SLC16A11 are a common risk factor for type 2 diabetes in Mexico. Nature. 2014;506(7486):97–101. https://doi.org/10.1038/nature12828
- Abi-Rached L, Jobin MJ, Kulkarni S, et al. The Shaping of Modern Human Immune Systems by Multiregional Admixture with Archaic Humans. Science. 2011;334(6052):89–94. https://doi.org/10.1126/science.1209202
- Ding Q, Hu Y, Xu S, et al. Neanderthal Introgression at Chromosome 3p21.31 Was Under Positive Natural Selection in East Asians. Mol Biol Evol. 2014;31(3):683–695. https://doi.org/10.1093/molbev/mst260
- Vernot B, Akey JM. Resurrecting Surviving Neandertal Lineages from Modern Human Genomes. Science. 2014;343(6174):1017–1021. https://doi.org/10.1126/science.1245938
- Sankararaman S, Mallick S, Dannemann M, et al. The genomic landscape of Neanderthal ancestry in present-day humans. Nature. 2014;507(7492):354–357. https://doi.org/10.1038/nature12961
- Prüfer K, Racimo F, Patterson N, et al. The complete genome sequence of a Neanderthal from the Altai Mountains. Nature. 2014;505(7481):43–49. https://doi.org/10.1038/nature12886
- Mafessoni F, Grote S, de Filippo C, et al. A high-coverage Neandertal genome from Chagyrskaya Cave. Proc Natl Acad Sci USA. 2020;117(26):15132–15136. https://doi.org/10.1073/pnas.2004944117
- Meyer M, Kircher M, Gansauge MT, et al. A High-Coverage Genome Sequence from an Archaic Denisovan Individual. Science. 2012;338(6104):222–226. https://doi.org/10.1126/science.1224344
- Ceballos FC, Joshi PK, Clark DW, et al. Runs of homozygosity: windows into population history and trait architecture. Nat Rev Genet. 2018;19(4):220–234. https://doi.org/10.1038/nrg.2017.109
- Mengel-From J, Thinggaard M, Dalgård C, et al. Mitochondrial DNA copy number in peripheral blood cells declines with age and is associated with general health among elderly. Hum Genet. 2014;133(9):1149–1159. https://doi.org/10.1007/s00439-014-1458-9
- Jaiswal S, Fontanillas P, Flannick J, et al. Age-Related Clonal Hematopoiesis Associated with Adverse Outcomes. N Engl J Med. 2014;371(26):2488–2498. https://doi.org/10.1056/NEJMoa1408617
- Genovese G, Kähler AK, Handsaker RE, et al. Clonal Hematopoiesis and Blood-Cancer Risk Inferred from Blood DNA Sequence. N Engl J Med. 2014;371(26):2477–2487. https://doi.org/10.1056/NEJMoa1409405
- Forsberg LA, Rasi C, Malmqvist N, et al. Mosaic loss of chromosome Y in peripheral blood is associated with shorter survival and higher risk of cancer. Nat Genet. 2014;46(6):624–628. https://doi.org/10.1038/ng.2966
- ISBT Working Party on Red Cell Immunogenetics and Blood Group Terminology. Blood group allele tables. https://www.isbtweb.org/isbt-working-parties/rcibgt.html
- Barker DJ, Maccari G, Georgiou X, et al. The IPD-IMGT/HLA Database. Nucleic Acids Res. 2023;51(D1):D1053–D1060. https://doi.org/10.1093/nar/gkac1011
- Gonzalez-Galarza FF, McCabe A, Santos EJMD, et al. Allele frequency net database (AFND) 2020 update: gold-standard data classification, open access genotype data and new query tools. Nucleic Acids Res. 2020;48(D1):D783–D788. https://doi.org/10.1093/nar/gkz1029
- Chung WH, Hung SI, Hong HS, et al. A marker for Stevens–Johnson syndrome. Nature. 2004;428(6982):486. https://doi.org/10.1038/428486a
- Hung SI, Chung WH, Liou LB, et al. HLA-B*5801 allele as a genetic marker for severe cutaneous adverse reactions caused by allopurinol. Proc Natl Acad Sci USA. 2005;102(11):4134–4139. https://doi.org/10.1073/pnas.0409500102
- Robinson J, Halliwell JA, McWilliam H, et al. IPD—the Immuno Polymorphism Database. Nucleic Acids Res. 2013;41(D1):D1234–D1240. https://doi.org/10.1093/nar/gks1140
- Dawkins R. The Selfish Gene. Oxford: Oxford University Press; 1976.
- Salter SJ, Cox MJ, Turek EM, et al. Reagent and laboratory contamination can critically impact sequence-based microbiome analyses. BMC Biol. 2014;12(1):87. https://doi.org/10.1186/s12915-014-0087-z
- Spandole S, Cimponeriu D, Berca LM, et al. Human anelloviruses: an update of molecular, epidemiological and clinical aspects. Arch Virol. 2015;160(4):893–908. https://doi.org/10.1007/s00705-015-2363-9
- Pellett PE, Ablashi DV, Ambros PF, et al. Chromosomally integrated human herpesvirus 6: questions and answers. Rev Med Virol. 2012;22(3):144–155. https://doi.org/10.1002/rmv.715
- Schulze JJ, Lundmark J, Garle M, et al. Doping Test Results Dependent on Genotype of Uridine Diphospho-Glucuronosyl Transferase 2B17, the Major Enzyme for Testosterone Glucuronidation. J Clin Endocrinol Metab. 2008;93(7):2500–2506. https://doi.org/10.1210/jc.2008-0218
- Perry GH, Dominy NJ, Claw KG, et al. Diet and the evolution of human amylase gene copy number variation. Nat Genet. 2007;39(10):1256–1260. https://doi.org/10.1038/ng2123
- Kronenberg F, Mora S, Stroes ESG, et al. Lipoprotein(a) in atherosclerotic cardiovascular disease and aortic stenosis: a European Atherosclerosis Society consensus statement. Eur Heart J. 2022;43(39):3925–3946. https://doi.org/10.1093/eurheartj/ehac361
- Sekar A, Bialas AR, de Rivera H, et al. Schizophrenia risk from complex variation of complement component 4. Nature. 2016;530(7589):177–183. https://doi.org/10.1038/nature16549
- Swen JJ, Nijenhuis M, de Boer A, et al. Pharmacogenetics: From Bench to Byte—An Update of Guidelines. Clin Pharmacol Ther. 2011;89(5):662–673. https://doi.org/10.1038/clpt.2011.34
- Chen X, Shen F, Gonzaludo N, et al. Cyrius: accurate CYP2D6 genotyping using whole-genome sequencing data. Pharmacogenomics J. 2021;21(2):251–261. https://doi.org/10.1038/s41397-020-00205-5
- Clinical Genomics Stockholm. Stranger: annotation of repeat expansions. https://github.com/Clinical-Genomics/stranger
- Cortese A, Simone R, Sullivan R, et al. Biallelic expansion of an intronic repeat in RFC1 is a common cause of late-onset ataxia. Nat Genet. 2019;51(4):649–658. https://doi.org/10.1038/s41588-019-0372-4
- Danecek P, Bonfield JK, Liddle J, et al. Twelve years of SAMtools and BCFtools. GigaScience. 2021;10(2):giab008. https://doi.org/10.1093/gigascience/giab008
- Li D, Mei H, Shen Y, et al. ECharts: A declarative framework for rapid construction of web-based visualization. Vis Inform. 2018;2(2):136–146. https://doi.org/10.1016/j.visinf.2018.04.011